这是本节的多页打印视图。 .
短文
- 1: 让 Claude Code 使用 tmux/screen 执行交互式操作
- 2: 为什么 JDK 的镜像比 JRE 镜像小?
- 3: 让 Claude Code 使用其他模型
- 4: comic-bbox-translator - 用 LLM 生成带边界框的翻译
- 5: Today I Learned - 更简单更频繁的分享
- 6: code2prompt - 满足「这是怎么做到的」好奇心的小工具
- 7: 游戏推荐 - A Short Hike
- 8: 读书记录《悟道领域驱动设计》
- 9: 不要在 gcc 7 里隐式捕获 constexpr 数组
- 10: 工具小站
- 11: 基于 WebRecorder 和 MitmProxy 的图片手动抓取探索
- 12: 如何手动 squash
- 13: 在 Devtools 里触发前端组件的内部状态更新
- 14: Obsidian 与工作日志
- 15: 读书记录《时间贫困》
- 16: 读书记录《软件设计的哲学(第2版)》
- 17: 多语言的 Hugo 博客
- 18: 我的 AI Prompt
- 19: 用 mitmproxy 让 ChatGLM 适配 OpenAI 接口
- 20: 用 mitmproxy 重定向 OpenAI 请求到 OpenRouter
- 21: 健身房等待时间模拟
- 22: 评论系统从 Disqus 迁移到 Giscus
- 23: 随机分享(230910):Typescript 中 Any 关闭类型检查 & Linux 中的内存占用
- 24: 播放 Lofi Girl 的小脚本
- 25: 在 devtool 控制台里爬网站
- 26: 用 CSS Filter 反色实现简易黑暗模式
- 27: VNC 连接到物理屏幕
- 28: 构造能匹配所有 emoji 的正则表达式
- 29: Go 监控协程数量
- 30: Go Timer 的使用姿势
- 31: MS RDP 无法连接到在使用了 802.1x 认证的无线网络中的电脑
- 32: Markdown 表格内的代码块
- 33: Python __hash__ 继承
- 34: mdBook 代码折行(wrap)
- 35: Hugo 的 Disqus 整合
- 36: JavaFX 打包并设定 UTF-8
- 37: 用 Slides 标题栏颜色区分重要性
- 38: WSL2, Docker, Virtualbox
分享一些小技巧。
1 - 让 Claude Code 使用 tmux/screen 执行交互式操作
起因是逛 YouTube 时看到了 Armin Ronacher 的这两个视频:
看起来很酷炫,但实际上原理很简单:screen/tmux 都支持通过命令行传递输入并返回当前正在展示的内容,只需要写个文档让 Claude Code 用就好了(见文末)。
- Screen:
-X stuff输入,-X hardcopy输出 - Tmux:
send-keys输入,capture-pane输出
甚至还可以 attach 上去看看在做什么。
- Screen:
screen -r ${session_name}(Ctrl+A D 释放) - Tmux:
tmux attach-session -t ${session_name}(Ctrl+B D 释放)
两者相比,tmux 似乎更好一些,因为 screen 只能输出到文件,llm 还需要再 read 一次;tmux 的输出直接在 stdout,不用多绕一道。
这是一个 GIF 示例,展示了 Claude Code 在 tmux 中使用 gdb 解决经典的 bomb lab 问题。(加速 10x)
这只是一个通用能力的展示;如果你真的想要用 gdb,可能 mcp-gdb 是更好的选择。
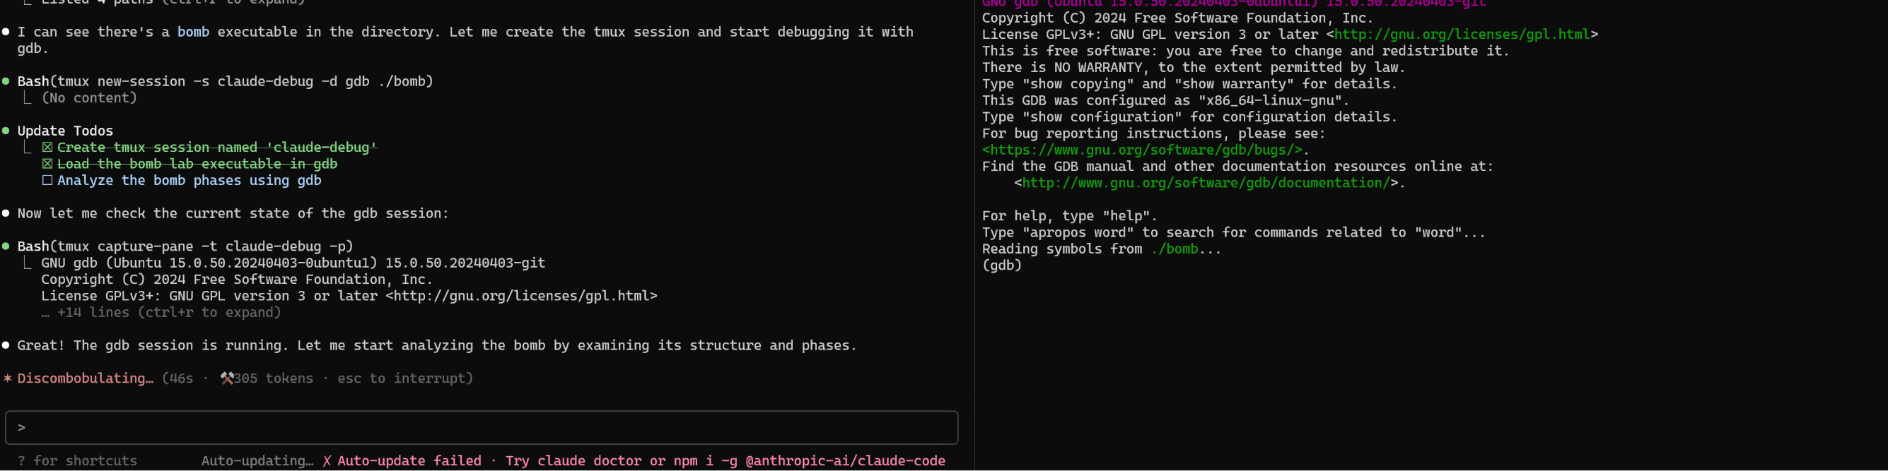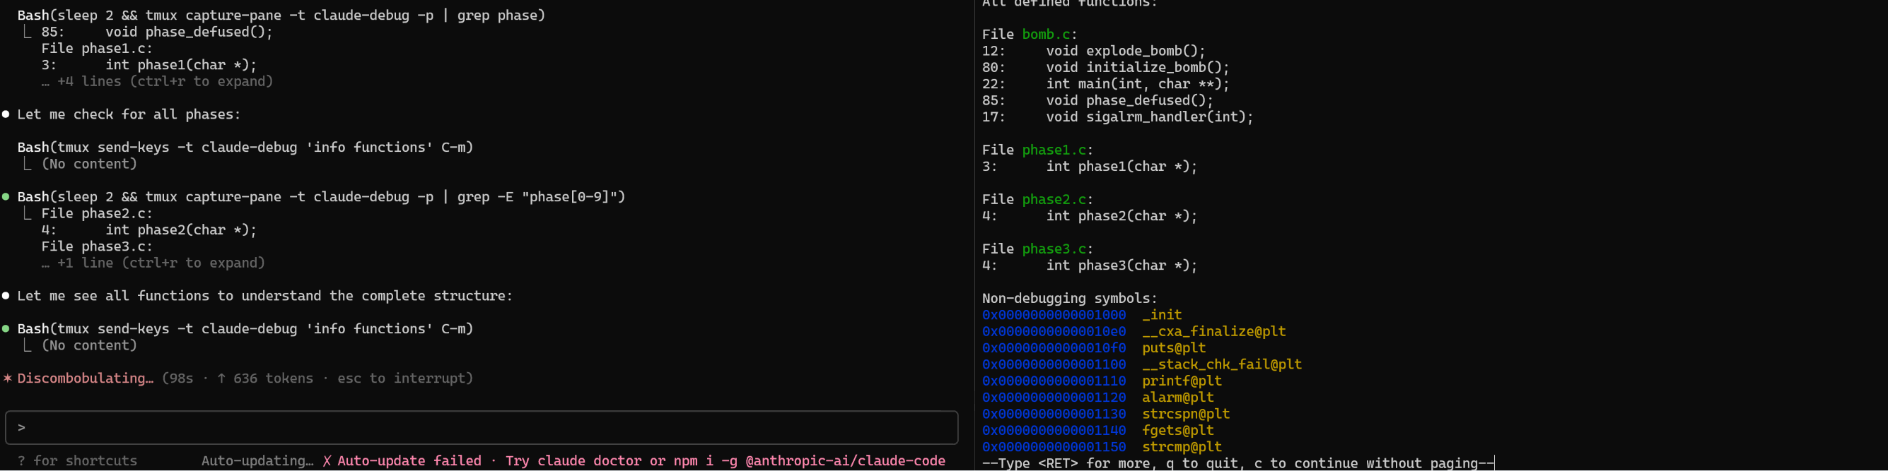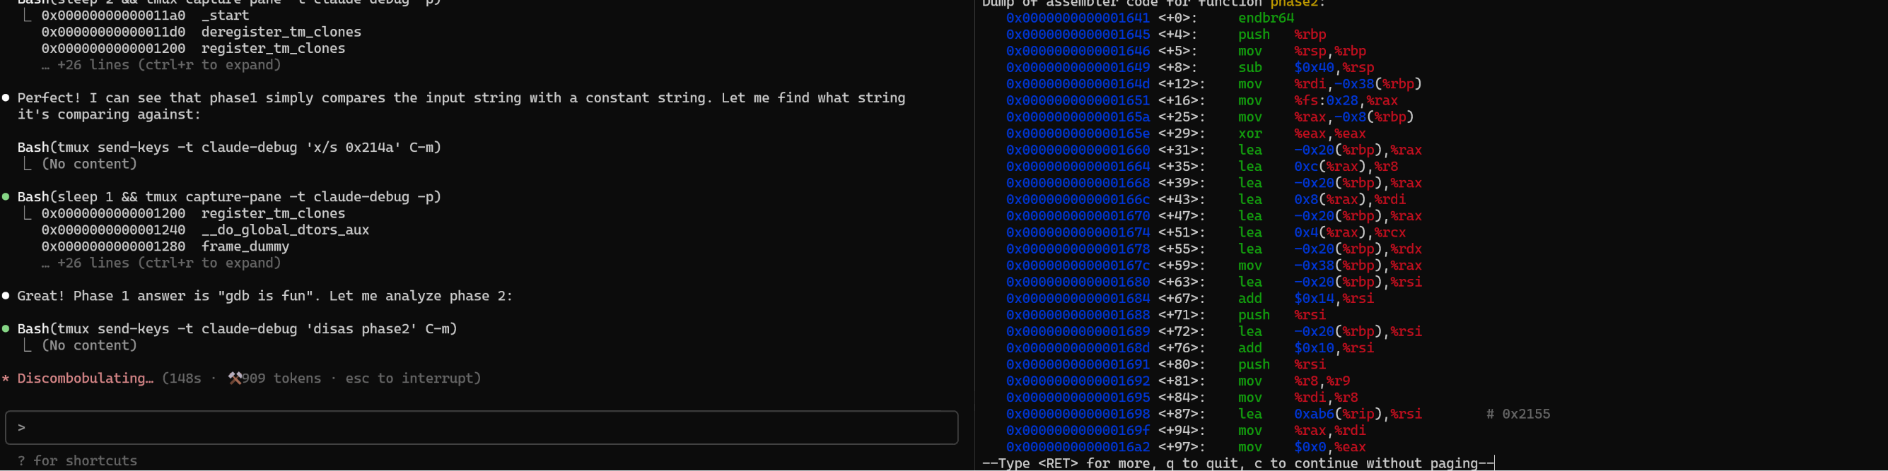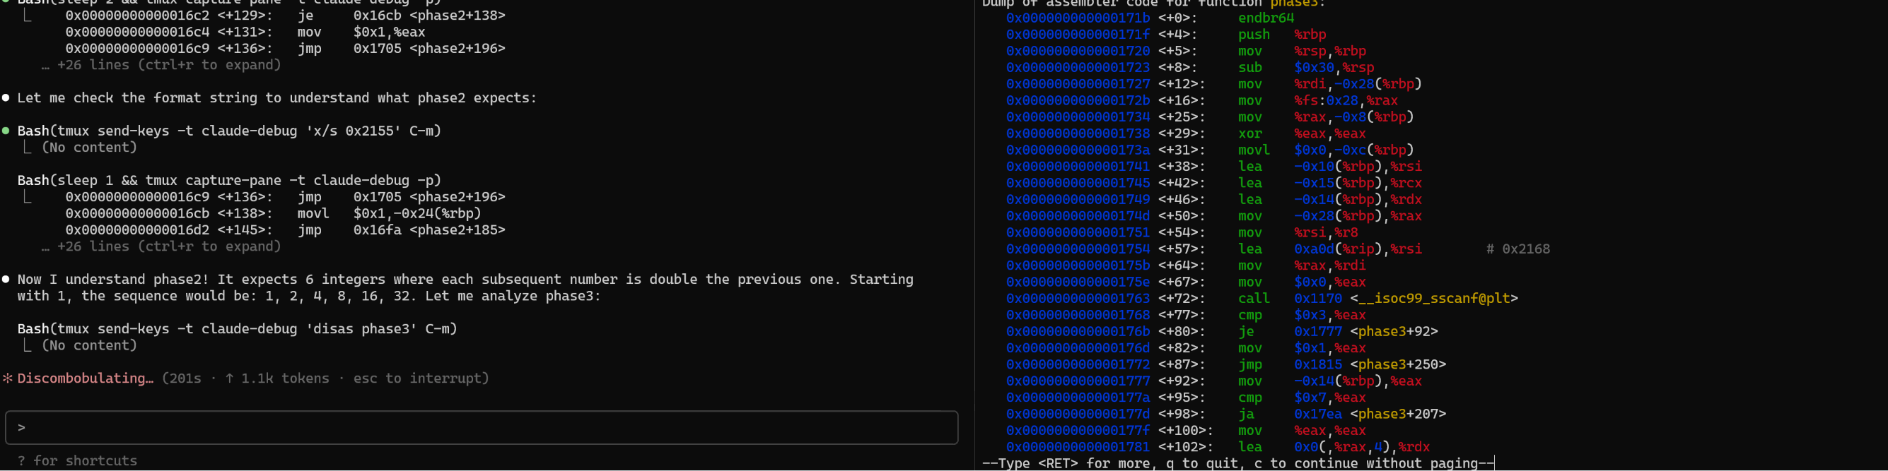
完整 prompt:
# Debugging Guide for AI Agents

This guide provides instructions for debugging using `gdb` within terminal multiplexers. It covers two options: `screen` and `tmux`. Use these multiplexers to run a command in a detached session, allowing for input sending, output capturing, and session management. Sessions are named using `${session_name}` for consistency.

Sessions can be started with a specific command (e.g., `gdb`) or empty, with commands sent later. Examples assume a session running `gdb`.

## Using Screen

- **Starting the Session**: Start a detached `screen` session named `${session_name}`. Use flags like `-S` (session name), `-d` (detach), and `-m` (create even if detached). The `${command}` can be `gdb [optional-program]` or any other command.

  ```bash
  screen -S ${session_name} -d -m ${command}
  # Example: screen -S my-debug-session -d -m gdb my_program
  # Example: screen -S my-shell-session -d -m bash
  ```

- **Sending Input**: Send strings or commands into the session using the `stuff` command. Use `$'\n'` for newlines.

  ```bash
  screen -S ${session_name} -X stuff $'${input_string}\n'
  # Example: screen -S my-debug-session -X stuff $'run < /usr/share/dict/words\n'
  # Example: screen -S my-shell-session -X stuff $'ls -l\n'
  ```

- **Reading Output**: Screen does not output directly to stdout, so use a workaround: Capture the session output to a text file using `-X hardcopy`, then read the file.

  ```bash
  screen -S ${session_name} -X hardcopy tmp_screen_out.txt
  cat tmp_screen_out.txt
  ```

- **Closing the Session**: When debugging is finished, quit the session.

  ```bash
  screen -S ${session_name} -X quit
  ```

## Using Tmux

- **Starting the Session**: Start a detached `tmux` session named `${session_name}`. Use `new-session` with `-s` (session name) and `-d` (detach). The `${command}` can be `gdb [optional-program]` or any other command.

  ```bash
  tmux new-session -s ${session_name} -d ${command}
  # Example: tmux new-session -s my-debug-session -d gdb my_program
  # Example: tmux new-session -s my-shell-session -d bash
  ```

- **Sending Input**: Send strings or commands into the session using `send-keys`. Use `C-m` for Enter (newline).

  ```bash
  tmux send-keys -t ${session_name} '${input_string}' C-m
  # Example: tmux send-keys -t my-debug-session 'run < /usr/share/dict/words' C-m
  # Example: tmux send-keys -t my-shell-session 'pwd' C-m
  ```

- **Reading Output**: Capture the pane output directly to stdout using `capture-pane` with `-p`.

  ```bash
  tmux capture-pane -t ${session_name} -p
  ```

- **Closing the Session**: When debugging is finished, kill the session.

  ```bash
  tmux kill-session -t ${session_name}
  ```
```
2 - 为什么 JDK 的镜像比 JRE 镜像小?
TLDR:虽然 JDK 镜像内容比 JRE 镜像多,但 JDK 镜像的压缩比更高,导致最后镜像大小反而 JDK 比 JRE 小;原因是 JDK 镜像主要用于 CI/CD 流水线,对性能和耗时要求不太高,所以可以用更高的压缩比;但 JRE 镜像主要用于线上服务,对性能要求极高,因此基本没有压缩。
AI 贡献提示:技术探索过程主要由 Claude Code + Kimi K2 完成;文字部分主要为 Gemini Pro 2.5 编写;我仅提供探索方向指导和简单内容编辑。我已在能力范围内确认下述内容的准确性。如发现问题,欢迎留言反馈。
感谢 @ziqin 提出了本文的探索问题。
缘起:一个反常的发现
一位群友在运行 docker image 时发现一个反常的现象:JDK镜像(111MB)竟然比JRE镜像(139MB)小了整整28MB!
但这感觉上不太合理,因为 JDK 是 JRE 的超集,不仅包含了 JRE 的全部功能,还包含了额外的开发工具(如 javac, jdb 等),为什么其镜像反倒还更小呢?这个反直觉的观察结果立刻激起了我们的好奇心。问题提出之时是个工作日的晚上,我并没有太多精力仔细思考,于是我让 Claude Code 来探索这个问题。
探案之旅:层层深入,拨开迷雾
我们的调查遵循着从宏观到微观的路径,一步步逼近问题的核心。
第一站:文件系统对比
我们首先通过 docker exec 进入两个正在运行的容器,对比其内部文件系统的差异。
- JDK 镜像:
docker exec jdk-analysis du -sh /usr/lib/jvm/liberica21-lite-> 98.5M - JRE 镜像:
docker exec jre-analysis du -sh /usr/lib/jvm/liberica21-container-jre-> 125.2M
初步结论:差异的根源在于Java安装目录本身。JDK镜像使用的是一个名为 liberica21-lite 的发行版,而JRE镜像使用的是 liberica21-container-jre。
第二站:核心文件对比
当我们继续深入,对比两者 lib 目录下的核心文件 modules 时,差异变得更加惊人:
- JDK
modules文件: 59.3MB - JRE
modules文件: 97.1MB
modules 文件是Java模块化系统的核心,存储了所有的运行时模块。JRE的modules文件竟然比JDK的大了37.8MB! 这几乎完全解释了镜像大小的差异。
但新的问题随之而来:JDK明明包含了更多的模块(如编译器 jdk.compiler、文档工具 jdk.javadoc 等),为什么它的 modules 文件反而更小?
| 对比项 | JDK (liberica21-lite) | JRE (liberica21-container-jre) | 差异 |
|---|---|---|---|
| 模块数量 | 69 个 | 49 个 | +20 个 |
modules 文件大小 | 59.3 MB | 97.1 MB | -37.8 MB |
更多的内容,却占用了更少的空间。这背后一定有更深层次的原因。
第三站:压缩策略对比
为了彻底搞清楚 modules 文件内部的秘密,我们使用 jimage 工具将其解压,并分析了其中包含的每一个资源。真相终于水落石出。
这并非内容差异,而是压缩策略的根本不同!
观察以下对比数据:
| 指标 | JDK (liberica21-lite) | JRE (liberica21-container-jre) | 证据 |
|---|---|---|---|
| 压缩算法 | DEFLATE (zlib) | DEFLATE (zlib) | jimage工具确认 |
| 压缩级别 | Level 9 (最大) | Level 0 (无) | 资源分析确认 |
| 总资源数 | 28,427 | 22,133 | jimage list --verbose |
| 压缩资源数 | 28,044 (98.7%) | 0 (0.0%) | |
| 未压缩资源数 | 383 (1.3%) | 22,133 (100.0%) | JRE裸奔存储 |
| 压缩后总大小 | 60.4 MB | 100.5 MB | JRE因元数据开销反而变大 |
| 压缩比 | 2.31 : 1 | 0.99 : 1 | JRE压缩比小于1 |
真正的技术根因:
- JDK (
liberica21-lite): 使用了激进的DEFLATE压缩(相当于jlink --compress=2,级别9)。它将所有工具和资源(包括开发工具、调试信息、所有区域设置)都包含进来,然后用最高效的算法进行压缩,以实现最小的磁盘占用。 - JRE (
liberica21-container-jre): 完全没有使用压缩(相当于jlink --compress=0,级别0/STORE模式)。它精心挑选了生产环境必需的运行时子集,但为了追求最快的启动速度和运行时性能,放弃了压缩。(甚至因为压缩元数据,反而引入了额外的空间开销,导致压缩比小于 1。)
设计哲学:为何如此选择?
这个看似矛盾的设计,实际上是BellSoft针对不同应用场景的深思熟虑的工程决策。
JDK “lite” 的设计目标 (--compress=2)
- 目标场景: CI/CD流水线、开发环境、容器构建阶段。
- 优化核心: 存储和网络效率。在这些场景下,镜像的下载速度和存储成本是首要考虑因素。构建时的一次性压缩CPU开销,可以换来后续无数次快速的分发和部署。
- 策略: 空间换时间(构建时)。牺牲构建时的CPU时间,换取最小的存储空间。
JRE “container-jre” 的设计目标 (--compress=0)
- 目标场景: 生产环境运行时。
- 优化核心: 运行时性能。在生产环境中,应用的启动速度、内存占用和CPU效率至关重要。免去解压步骤,意味着更快的类加载、更低的CPU消耗和更少的内存抖动。
- 策略: 时间换空间(运行时)。牺牲磁盘空间,换取运行时的高性能和稳定性。
最终结论:一个反直觉的真理
我们最初的谜题现在有了清晰的答案:
JDK镜像小,是因为它用极致的压缩,换取了分发和存储的便利。 JRE镜像大,是因为它用空间,换取了生产环境的极致性能。
换句话说:
- 更多内容 + 更强压缩 = 更小的分发体积 (JDK)
- 更少内容 + 无压缩 = 更大的分发体积 (JRE)
结语
这次从一个简单的 docker images 命令开始的探案之旅,最终带领我们深入理解了现代 Java 发行版在容器化时代的精妙设计。BellSoft Liberica 的这种差异化策略,并非一个错误,而是一个深刻理解开发者和运维者在不同阶段核心痛点的高级功能。
它告诉我们,在技术的选择上,没有绝对的“好”与“坏”,只有是否“适合”。理解了这些选择背后的逻辑,我们才能在自己的工作中,做出更明智、更高效的决策。
3 - 让 Claude Code 使用其他模型
最近在尝试各类 agent 项目,大部分都支持使用任何 OpenAI 兼容 API 格式的模型提供商,但是作为这个流派最著名的 Claude Code 却只能用自家模型。自家模型其实也不错,但是对我这种无法在生产环境使用,只是用来自己探索和 side project 的场景下太贵了。搜了下似乎没有人介绍过如何让 Claude Code 和非官方模型配合使用,于是决定记录下。
这一方法的核心是 Claude Bridge 这个项目。实现上,和任何计算机科学问题的解决方式一样,加了一个中间层。具体而言,是 patch 了 node 的 fetch 方法,拦截所有向 Anthropic 官方的请求,转换成标准的 OpenAI 格式(其实是作者自己的一个统一 format),调用指定的提供商,在流式响应的时候再转换回 Claude 的 SSE 格式。
- 安装依赖
- 准备 API Key 提供脚本
这一步参考了 Claude Code 的一个 issue How can I use my API key without signing in?,以及这篇文章 Setting up Claude-Code with API Key。
本步骤解决的问题是,Claude Code 默认情况下只能以 Claude 账号的形式登录(重定向到官方登录页),但不能在不登入账号的情况下直接使用 API Key 发起请求。然而实际上有办法绕过这一限制,只需要创建一个 apiKeyHelper 即可。
首先在 ~/.claude/settings.json 中增加如下内容。(文件没有的话可以先创建)
然后创建 ~/.claude/anthropic_key.sh,填入如下内容:
(因为我们会用第三方模型提供商,所以这里可以随便填写)
最后给让这个 shell 脚本可执行。
- 运行 Claude Code
用目标提供商和模型替换命令中的参数即可。第一个 openai 参数是提供商格式,也可以换成 gemini 等。详情请参考 Claude Bridge 的 readme 文件。
当然这一方法也不是万能的,有一些已知限制:
- token 计数不准
- 不能输入图片
- 网络搜索/fetch 不可用
- thinking/reasoning 部分可能无法被正常解析
(之后可能会写一篇文章对比不同的 agent,但是得看有没有时间了…)
4 - comic-bbox-translator - 用 LLM 生成带边界框的翻译
起因是在看推上的日语同人;如果用 LLM 直接翻译的话,无论加了什么prompt,最后翻译出来的顺序也是乱的(可能是因为视觉模型内在的处理顺序问题?),需要脑内重排序,不太爽;正巧之前看到过其他人的博客,说现在视觉模型可以输出边界框了,于是趁着放假 vibe coding 了一把,果然还真可以用;虽然边界框偶尔不太准,但是大部分场景下也足够了。起初用 Python 写了一个版本,但后面意识到其实可以直接用 Web 技术实现,省的用户另外配置环境了。
5 - Today I Learned - 更简单更频繁的分享
对我来说,写文章其实是心理门槛挺高的一件事,会觉得得对某个事物充分了解,完全掌握了,才有动力去下笔。(虽然大概这里的文章并没有达到这样一个状态。)但也有时候,我见到了一个有趣或者有用的事物,可能是一篇论文、一个项目、一条视频,或者只是简单的一个想法,会有分享的欲望。为此写文章有些太大动干戈了,但是不将他们分享出去又有些可惜。现实生活里我有一个小群来分享这些东西,但我认为它们值得被更多人看到。
因此,在我经常阅读的另外两位创作者 Simon Willision 和 Julia Evans 的启发下,去年年底我创建了一个名为 TIL (Today I Learned) 的分类。形态上类似于微博或者 Reddit,基本上都是一个链接 + 一些简短的介绍,意图在于让读者快速了解这些事物是否对 ta 们有帮助,并将流量引导到原作者。
但创建这个分类之后,我发现自己的分享频率并没有显著上升。后来我意识到,虽然有了单独的分类,但是发布行为本身并没有简化。即使我只是想快速分享一个链接,我依然要采用和正式文章完全相同的方式:在编辑器里新建一个 Markdown 文件,写 front matter 和文章正文,预览,推送到 Github 仓库。如果这个新分类的定位类似于微博,那为什么不能像真的发微博那样简单呢?
这个月初,我调整了下 TIL 的发布方式,做法类似于 headless CMS。具体而言,在某个地址有一个简单的页面,里面有一些基本字段(标题、URL)和一个 Markdown 编辑器,还有一个“发布”按钮。在我填充完基本信息,点击“发布”之后,会触发一个云函数,读取请求,调用 Github API 完成 Repo 内新文件的写入。虽然技术上来看这并不复杂,但却极大减少了发布的心理负担。现在当我想分享的时候,只要打开这个页面,快速把内心的感受 dump 进去,点击发布,就算完成了。
当然,考虑到 TIL 形式的分享贴所含的信息量更低,不能排除正常读者会被打扰的可能性。为此,我修改了 Hugo 的 RSS 模板,将 TIL 和正常文章拆分成了两个 RSS 源。TIL 的分享只会在单独的 TIL 订阅源中出现,以确保读者只有在明确想收到这些分享的时候才会收到。(这也是从 Simon Willison 那里学到的,他有一个名为 atom-everything 的订阅入口。)
最后是一些相关链接。希望你也能发现我的 TIL 对你有帮助。感谢阅读!
6 - code2prompt - 满足「这是怎么做到的」好奇心的小工具
我发现自己经常对着一个有趣的 Github Repo 思考:「这看起来真不错!但是究竟是怎么做到的?」。但很多时候我无法满足我的好奇心。要么是这个项目并没有自带一个「How it works / 工作原理」的介绍(在我看来这应该是每个项目 README 的必备),要么是我没有时间或者耐心在层层叠叠的文件树或者错综复杂的调用链里自己找到答案。得益于近来 LLM 的上下文窗口增长,让 LLM 来帮我回答这一问题似乎是个不错的选择。即使 LLM 回答给出的答案可能有错误或者不完整,但至少能给出一些探索方向,让我自己的理解更有效率。然而在通常的对话窗口里复制粘贴代码有些烦人,更别提无法在文件数多的项目里应用了。为此,我(让 LLM)帮我写了一个小工具,让我能更方便的从代码生成发送给 LLM 的 prompt。
如何使用
具体使用起来很简单:
- 在GitHub项目页面,点击右上角"Code"→“Download Zip"下载代码
- 打开工具页面,点击"选择文件"并上传刚下载的zip包
- 根据文件数量或token大小进行筛选(比如排除test/、vendor/或package-lock.json等无关文件)
- 点击"Generate"生成提示词
- 点击"Copy"复制到剪贴板,然后粘贴到你喜欢的LLM对话工具中
还有一些其他特性:
- 文件树可以一次选中/取消选中整个文件夹
- 每个文件旁标记了该文件的大小和 token 预估
- 点击文件,可以直接展示该文件的内容(monaco editor)
实现原理
- 解析zip文件(jszip 库)
- 计算每个文件的token占用(用的是 gpt-tokenizer,基于 cl100k 计算,也就是 gpt-3.5-turbo 的分词器)
- 展示文件列表和占用空间最大的文件,并根据选择更新
- 最后用文件内容填充预设的提示模板
使用技巧
- 模型:用上下文足够长的模型,注意上下文限制;如果有可能的话用带上下文缓存的提供商
- 比较推荐的模型
- Gemini 2.0 Flash Lite:输入 ¥0.55/1m, 输出 ¥2.19/1m, 上下文 1m
- qwen-turbo:输入 ¥0.3/1m, 输出 ¥0.6/1m out, 上下文 1m
- 如果最后得到的 token 数少,再考虑 deepseek-v3(官方上下文 64k,部分提供商 128k)等模型
- 比较推荐的模型
- 筛选:根据自己的需要提前删掉不需要的文件
- 二进制文件已经预先被筛掉了,不会出现在文件树里
- test / vendor / docker 相关的通常可以做排除
- 如果只看后端,则可以把前端的全排除掉
- 提示词:建议加在输入的最后,避免模型丢失焦点
- 首次阅读:简要说明代码做了什么, 以及是如何做到的。列出核心函数所在的位置。
- 理解流程:用 mermaid sequence diagram 说明 XXX 的完整流程
- 分析结构:这个项目主要有哪些组成部分?用 mermaid flowchart 展示
开发
- 大部分都是 LLM 写的(Windsurf + Claude),人主要是测试和提出修改意见。
- 目前并没有用任何前端框架,都是裸 DOM 操作。(主要原因是没找到一个比较好的不需要构建过程的前端框架使用方式)。
- 一开始的时候只是一个简单的单页面(所有代码都在 index.html)里的小应用,但随着复杂度上升和功能增加不得不做重构,拆分多个文件(不然的话编辑操作会因为影响行数过多常常失败)。未来可能一开始就考虑多文件架构会比较合适。
- 目前每次 LLM 改完之后,得靠人手动操作下来验证是否有功能被破坏,有点麻烦。要是能有更自动化的 E2E 测试(例如基于 Playwright)就好了。
可能的后续方向
- 直接从 Github 加载:目前直连 Github 下载 zip 会有 CORS 问题,需要一个后端来代理下(但是就引入额外的运行成本了;我还是更喜欢纯前端而不依赖任何后端的工具)
- 预设提示词:提供几个常用提示模板方便一键使用
- 本地文件夹支持:直接加载本地项目文件夹
- gitignore支持:自动忽略.gitignore中指定的文件
其他方案对比
- Cursor / Windsurf:需要依赖编辑器自己去读取文件,慢而且可能会缺失文件
- repofix:开发之后才关注到,前端缺少控制能力,用起来不太方便
- files-to-prompt:纯命令行工具,对我这种临时性探索稍微有点繁琐(但是用在其他工作流里可能比较合适)
7 - 游戏推荐 - A Short Hike
我很少主动玩游戏。虽然有时会看其他人的游玩/剧情视频,但是自己实际上手玩的几乎没有。可能是小学的时候玩得足够多,长大之后反而对游戏失去了兴趣。我不想在竞技类游戏里比拼分数,也不想在策略类游戏里消耗脑力,更不想在吃操作的游戏里磨炼键位。日常生活已经够累了,何必再在游戏里自寻烦恼呢?但是 A Short Hike 让我体会到了不一样的感受。这是一个玩起来放松、甚至治愈的游戏。(用番剧类比的话,就像《摇曳露营》的第一季。)它让我如此惊喜,以至我甚至愿意专门写这篇短文来推荐。
为什么它能有这样的神奇效果呢?我没法指出一个确切的原因,但是以下这些优点可能都有帮助。
- 主线直接、支线丰富:主线剧情很简单,正如其名,爬到山顶就完成了,一般 2h 内就可以完成。但主线之外,还有各种各样的支线任务(钓鱼、划船、赛跑…),即使完成了主线,到了 end game 阶段也不会感到空虚;现在我依然会时不时打开,让自己放空一会。
- 世界小、密度大:虽然游戏内的世界并不算大(一座大岛 + 几座小岛),但是地图设计很精致,跑图探索的时候会感觉每个方向都有事做。另外地图是完全开放的,想去哪就去哪,完全自由,不像一些开放世界游戏,需要完成前置任务或者是满足前置条件,才能解锁接下来的区域。
- 操作友好、上手简单:作为游戏苦手,操作不是我的强项,但游戏内实际上只需要方向键移动和两个动作键(Z爬墙/滑翔,X操作工具),即使是很少玩游戏的我也能轻易上手;难度的渐进(通过耐力条金羽毛控制)也很合理,正常流程基本不会遇到卡关的情况,甚至还能探索出很多非预期解法;滑翔的体验非常棒,每次都让人意犹未尽。
- 交互机制精妙:这里的交互指的是游戏内玩家和游戏世界的交互,而不是指用输入设备操作游戏;游戏内有一些特殊的工具(例如水桶、铲子)可以在多种场景下使用,而且非常直观,你觉得应该能行的操作很多时候还真能行。(甚至还有隐藏成就)
- 对话有趣、角色立体:游戏没有配音,只有文字对话,且语句都很简短;但因为对话写的好,无论是主角,还是游戏里的其他 NPC 的形象都很立体,并不会觉得是普通的可以被任意替换的角色;甚至还有剧情弧光,一开始以为的坏人后来发现也有苦衷。
- 画风独特、色彩明亮:用文字描述起来有些困难,去 Steam 页面看看预览图就懂了;像素大小可以根据自己的需要调整。
- 音乐宁静:不同地区有自己的 BGM,而且是动态分层的,随着剧情进展会有变化;OST 已经加入我的歌单。
虽然优点很多,但是依然有一些小小的缺憾:
- 固定视角:游戏内方向键只能操作主角的移动,视角方向是游戏自动切换的;虽然大部分情况下都很合理,但是有的时候自动切换会非常突兀。(明明移动方向不变,但是因为视角切换了,所以方向键输入也需要切换)
- 没有游戏内地图:虽然玩的多会形成心理地图,但是还是会时不时迷路。
总评:9/10 (神作)
- 一个适合于所有人的游戏
相关链接:
- Steam 商店页面:A Short Hike
- 原价 32 元,购入时 40% off,实际购入价格 19.2 元
- 无官方简体中文支持,但是可以打社区补丁(英文用词不复杂,直接玩也行)
- 作者在 GDC 上的回顾演讲:Crafting A Tiny Open World: A Short Hike Postmortem
- 说起来这个游戏进入我的视野,是因为 YouTube 向我推荐了这个视频;即使没有时间玩游戏,这个视频依然很有趣
- 对音乐的分析:Musical Maps in A Short Hike (feat. Mark Sparling)
- 在线地图:Interactive Map - A Short Hike
8 - 读书记录《悟道领域驱动设计》
- ch2 应用架构
- 贫血模型 vs 充血模型
- 贫血模型:类只是数据容器,没有行为(例如 pojo)
- 充血模型:类有属性(数据),也有方法(行为)
- 项目结构
- 接口层:对外暴露api/消息consumer
- 应用服务层:协调领域模型完成业务逻辑
- 基础设施层:写db/缓存/调外部服务
- 领域层:领域内的具体逻辑
- 查询的两种实现
- 1 读数据后加载领域模型(聚合根),聚合根转换为查询结果 view
- 2 直接用实际存储的数据模型,跳过领域对象加载,直接用把数据模型转换为查询结果 view
- 贫血模型 vs 充血模型
- ch3 实体和值对象
- 实体:有唯一标识的领域模型
- e.g. 内容发布系统的文章
- 值对象:没有唯一标识,需要的时候随时构造,值一样就认为是相同的对象
- e.g. 内容发布系统的文章标题
- DP:Domain Primitive 领域内的基本数据类型,值对象的一种
- e.g. 金融系统中的金额(money)
- 实体:有唯一标识的领域模型
- ch4 聚合与聚合根
- 聚合:一组对象组成的对象树
- 单个实体也是聚合
- 聚合是一致性的边界;聚合内强一致,跨聚合最终一致
- 一个事务只更新单个聚合
- 聚合根:这个对象树的入口
- 单个实体也可以是聚合根
- 外部对象只能引用聚合根(通常通过持有一个id)
- 拆分聚合
- 一个实体被多个聚合根引用,应该被提升为聚合根
- 1:N 的集合属性(Role-Resource Binding),因为存在双向查找的需要(Role找Resource,Resource找Role),通常也可能被提升为聚合根
- 聚合:一组对象组成的对象树
- ch5 Factory, Repo, 领域服务
- Factory:从无到有创建领域对象
- 需要分配 id
- 通常用 builder 模式
- Repo:保存和加载聚合根,和实际的存储解耦
- save:聚合根持久化到数据库
- 注意事务控制,所有实际的写操作应该在一个事务内执行(例如文章写一个表,文章内容写另一个表)
- load:从数据库查询数据对象,组装回聚合根
- 推荐实现行级 repo,一个聚合根对应数据库中一行数据
- 如果存在查多行的需求,如 queryList,应该用 CQRS 分离出去
- save:聚合根持久化到数据库
- 领域服务:包含领域中不适合放在实体/值对象的业务操作,应该是无状态的
- 例子:导出数据为 excel
- Factory:从无到有创建领域对象
- ch6 设计模式
- 责任链:多个handler逐个执行
- 策略:从多种算法实现中选择一个(根据业务类型匹配到策略)
- 桥接
- 规约:验证复杂规则
- ch7 防腐层 ACL
- 避免外部系统变更影响到当前系统(字段名变化、包名变化…)
- 实现:适配器模式
- 出入参数应该是本地值对象,或者基本数据类型
- 外部异常/错误码应该转换为本地异常/错误码
- 只返回实际需要的字段
- 一般在应用服务/领域服务调用防腐层,不要在实体和值对象使用
- ch8 领域事件
- 幂等实现:数据库唯一索引 / 状态机
- 事件建模:用领域语言(例如账户被激活);建模为值对象/贫血对象(不可变的)
- 应用
- 触发其他领域/聚合的行为
- 记录状态变化
- 事件消息体:实体id,事件id,事件类型,发生事件
- 也可选包含具体数据,减少查询需要,例如用户变更手机号事件带上新的手机号
- 生成事件
- 应用层创建:推荐,直接在应用层生成,然后调用基础服务发布
- 聚合根创建:聚合根内生成事件,存储在聚合根内一个临时位置,应用层调用方法从聚合根取得,然后调用基础服务进行发布
- 发布事件
- 问题:保存聚合根和发布领域事件应该是一个事务,不能一个失败一个成功;但是引入分布式事务会造成复杂度上升
- 解决:用一个db里事件表,repo save的时候不仅写聚合根,还写事件表;然后用事件表变更触发mq
- 轮询补偿:一个外部定时任务,检查事件表中状态=未发布的事件,读出来发mq,然后更新状态为已发布
- 拖尾:用一个db拖尾组件监听db变更,自动发布到mq
- 订阅事件:事件 consumer 作为一个新的接口层,调用应用层服务
- 注意幂等
- ch9 CQRS
- 问题:查询的时候加载聚合根可能没必要(例如只读取一部分字段);但是修改的时候必须要加载完整聚合根
- CQRS 应用层分为 查询 query 和 修改 command 两部分,分别用不同的模型处理
- command 依然加载完整聚合根
- query 直接用数据模型(db数据)进行查询,转换为需要的返回 view
- 实现
- 同数据源:比较简单,query 不用 repo.load 而是直接读db
- 异数据源:复杂,可能导致不一致
- 需求:主数据存储 mysql,用 es 做文本搜索
- 实现:应用层发布领域事件,db日志拖尾
- 查询可以是一个贫血模型,因为没有复杂逻辑且只读数据不修改
- 缺点:复杂度高、可能导致数据一致性问题、增加学习成本
- ch10 事件溯源
- 想法:存储领域事件,读取时通过重放领域事件得到最新聚合状态
- 优点:完整业务跟踪能力;可以回滚到任意时刻的聚合根
- 实现1:最原始的实现,直接存领域事件,读时回放
- 只有一个事件表
- 实现2:事件多查起来慢,因此加快照,回放时用 上次快照 + 上次快照后的事件
- 事件表 + 快照表,save的时候可能需要生成快照
- 实现3:快照表用拉链表实现,存储所有事件+聚合根所有版本(含有效期)
- 拉链表:含有开始时间和结束时间,表明这一行数据在此时间段内有效
- 想法:存储领域事件,读取时通过重放领域事件得到最新聚合状态
- ch11 一致性
- 聚合内一致性
- 事务应该在 repo 实现,不应该在应用层实现,否则会造成事务过大
- 用乐观锁避免并发更新问题
- repo save 失败,需要在应用层重试,来确保聚合数据是最新状态(即重新 load)
- 因为会重新调用外部接口,依赖的外部接口应该幂等
- 不适合频繁更新的热点数据(可能导致频繁重试)
- 重试次数规划好,一般一次就够了,多次的话应该考虑其他架构
- 重试次数/触发原因可配置,一般只有乐观锁失败再重试,其他错误不应该重试
- 读写性能问题
- 一般业务做不到那么大
- 读多写少:读写分离、缓存、复杂查询维护单独的读数据源、分库分表
- 写之前的确需要完整加载聚合,写慢点就忍吧
- 跨聚合一致性:实际上是分布式事务
- 二阶段提交:prepare, commit;commit 可能失败,此时rollback
- 代价比较大
- 本地消息表+发布领域事件:见 ch8
- 最大努力通知:上游不断发起通知调用给下游,直到下游确认
- 适用于对可靠性要求不高
- 发起者需要提供查单接口,供接收者主动查询状态
- 发起者需要实现重复通知,接收者自己保证幂等
- 发通知间隔应该指数退避,且限制最大次数,避免无限发送
- TCC:try, confirm, cancel;try成功了confirm必须成功
- 注意点1 幂等:confirm/cancel幂等
- 注意点2 空回滚:没有调用try就调用了cancel;收到cancel查资源状态,没try过应该直接返回
- 注意点3 事务悬挂:先执行cancel再执行try;收到try查资源状态,被cancel过也直接返回
- saga:正向perform,补偿compensate
- 注意点1 隔离性:正向操作完成后,其他事务已经能观察到了,负向回滚之后可能影响到其他事务(用户看到订单消失)
- 考虑引入一个中间状态例如 pending
- 注意点2 幂等:perform/compensate 都应该幂等
- 注意点3 空回滚:没有perform就compensate;补偿前用业务主键查是否有perform,没有直接返回,并记录已回滚
- 注意点4 事务悬挂:先compensate再perform;perform前查询是否compensate过,有则报错
- 注意点1 隔离性:正向操作完成后,其他事务已经能观察到了,负向回滚之后可能影响到其他事务(用户看到订单消失)
- 选型
- 不要求实时,只要求最终一致:本地消息表、最大努力通知
- 要求实时:TCC
- 长事务、涉及外部/遗留系统:saga
- 二阶段提交:prepare, commit;commit 可能失败,此时rollback
- 聚合内一致性
- ch12 战略设计
- 概念
- 限界上下文:一个特定业务内的概念、规则、流程
- 如电商系统中的订单、商品、营销、物流
- 上下文映射:不同限界上下文之间的协作关系
- 子域:关联性强的限界上下文形成的大的业务概念
- 主播+直播 -> 视频直播子域
- 限界上下文:一个特定业务内的概念、规则、流程
- 划分限界上下文:按照业务边界
- 上下文映射
- 共享内核:存在共享的代码、领域模型、基础设施等
- 客户 供应商:客户(下游)给供应商(上游)提要求,如加接口、加字段
- 跟随者:上游不响应下游要求,下游得自己做
- 各行其道:上下游完全不关联
- 子域类型
- 核心子域:业务系统最重要的部分,业务价值高
- 支撑子域:起到支撑作用,但是没有成熟/通用方案,需要自己构建
- 通用子域:有通用性,存在成熟/通用方案,可以通过采购/开源获得
- 概念
- ch13 领域建模
- 事件风暴法:收集所有领域事件,归纳领域模型
- 收集内容
- 领域事件
- 命令:触发领域事件
- actor:命令的人为发起者
- 策略:命令的规则发起者,满足某种条件自动触发;定时任务也算
- 外部系统:也是命令的发起者
- 聚合
- 读模型:actor 发起命令前读的数据(例如审核员查看内容),需要这些数据辅助决策
- 热点:待定问题
- 建模流程
- 列举领域事件
- 按业务流程排序领域事件;无法连接的说明可能遗漏了
- 补充命令
- 补充发起者
- 提取聚合:同一个聚合的领域事件归类到一起
- 补充读模型
- 划分限界上下文,标注映射关系;注意需要标记上下游
- 划分子域
- ch14 研发效能
- maven 脚手架
- 响应封装 graceful response
- 对象转换 mapstruct
- 静态分析
- 低代码
- 持续集成/持续交付/持续部署
- ch15 测试驱动开发 tdd
- 红绿循环:写测试、测试失败、写代码、测试通过、重构、测试通过
- 贫血模式的 tdd
- dao:生成的,一般不用测
- service:对基础设施的调用应该 mock
- controller:mockmvc 直接测试 http 请求,验证响应(如返回码)
- ddd 中的 tdd
- 实体:测全分支;不应该依赖启动容器和基础设施
- 值对象:覆盖业务规则
- factory
- ch16 敏捷开发
- scrum
- 看板
- ch17 架构可视化
- c4 模型
- 系统上下文图:只展示核心系统、支持元素(如外部依赖、用户)
- 容器图:展示主要数据选型和个容器的职责分工
- 容器:可独立运行/部署的单元(如后台单体、缓存、数据库)
- 组件图:展示可执行容器内部分工,指导开发
- 代码图:UML/ER图,不推荐画(变更频繁)
- 其他图
- 系统全景图:展示关联的所有系统
- 动态图:展示元素在运行时如何协作,用箭头和编号表示顺序
- 部署图:说明部署方案,含有实例数量、机房等
- c4 模型
- ch18 重构
- 模式
- 修缮者:实现新方法,保留老方法,用开关切换,无问题后删除老方法
- 绞杀者:设计新系统,用一个门面承接流量,逐渐在新系统实现功能,并切老系统的流量到新系统,直到老系统完全无流量
- 推翻重建:彻底放弃老系统
- 流程
- 启动
- 必要性评估:考虑性能、可靠性、技术栈、业务支持、研发效率、运营效率
- 环境因素:企业战略、组织架构稳定性、文化氛围、管理风格
- 效益和风险分析
- 可行性分析:天时(和企业战略一致)、地利(已具备环境条件)、人和(团队愿意支持思想一致)
- 干系人识别:团队成员、管理者、职能部门负责人、最终用户
- 规划
- 确认重构范围
- 工作任务分解:任务分给唯一的某个人完成,可以向其他组员寻求帮助,但是负责人只有一个
- 工期估算和进度计划
- 沟通计划:管理层、项目成员、外部团队
- 人力资源计划:人力不足需要申请人力、提前培训
- 质量管理计划:业务流程梳理用力、数据一致性对比
- 执行
- 组建团队
- 梳理现有业务逻辑:读代码、读历史文档、头脑风暴
- 整理用例并评审
- 实施开发:DDD、敏捷、测试驱动、CICD
- 数据迁移
- 灰度切量
- 老系统下线:老系统可能还有调用者
- 监控
- 进度
- 质量
- 待办项
- 收尾
- 沉淀过程资产:架构图、FAQ、接口文档
- 推动新系统普及:通知调用方
- 启动
- 数据迁移的实现
- 方案1:双写
- 步骤1:老系统开始写入新数据源;新系统需要支持写老数据源
- 步骤2:历史数据从老数据源全量迁移到新数据源;检查新老数据一致性
- 步骤3:读验证,灰度部分读流量到新系统
- 步骤4:写验证,灰度部分写流量到新系统(新系统依然写老数据源,且定期校验)
- 步骤5:全部流量切换到新系统,新系统双写老数据源
- 步骤6:新系统稳定后,关闭新系统写老数据源开关,老系统下线
- 方案2:双向数据同步
- 正向:老->新:传输老系统的所有数据
- 反向:新->老:只传输新系统生成的数据(对来自老系统的数据有特殊标记)
- 步骤:正向链路一直打开,全量数据从老系统迁移到新系统,且保证增量同步;写验证前打开反向链路,直到老系统下线
- 方案1:双写
- 模式
- ch19 布道领域驱动设计
- 编码指南
9 - 不要在 gcc 7 里隐式捕获 constexpr 数组
如果你还没有遇到过 compiler bug,说明你写的代码还不够多。 —— 一位本科同学
虽然经常能看到其他人遇到 compiler 导致的意外现象,自己遇到却还是第一次,因此还是写篇文章小小记录下。
因为一些原因,目前工作中使用的 gcc 版本是 7.4。接到一个业务需求,需要对某些特定的用户打开一个 feature flag,且需要在代码里硬编码。代码很快就写完了,自测的时候却发现不太对劲。相关代码简化脱敏后如下所示。逻辑很简单,就是把可以进入灰度的用户 id 放到了一个 allowlist 里,然后检查当前的请求涉及到的所有用户 id 是否都在这个 allowlist 中。奇怪之处在于,在 gcc 7.4 下,如果用了 std::any_of 来找,即便用户不在灰度列表中,列表成员检查也会返回 true,导致意外的灰度进入;简单的 for 循环则没有这个问题。
因为需求要的比较着急,就先用 for 循环替换了。后面有空的时候尝试继续简化代码,可以得到如下的最小复现 POC:定义一个 constexpr 数组,创建一个 lambda 表达式,用[&]隐式捕获这个数组,最后在闭包中多次获取其地址;会惊喜的发现,每次获取的地址是不一样的!(可以在 Compiler Explorer 自己试试:https://godbolt.org/z/qdTfP81xn)
输出如下:
从生成的汇编中可以发现,在闭包里每次访问 arr 时候,其实都在栈上临时创建了一个副本,因此每次获取到的 arr 地址都是不一致的。
这也就能解释为什么之前在 std::any_of 闭包里用 std::find 会有问题了:其中作为参数的 std::begin(allowlist), std::end(allowlist) 和最后一个用于比较的 std::end(allowlist),三个 allowlist 的地址都不一样,因此这个 != 判定始终会成功,表现上就是会认为用户总是在灰度列表中了。
这是不是一个 compiler bug 呢?正如文章标题,我只是把这作为一个 unexpected behavior,因为编译器可以自行选择对 constexpr 的优化方式。我也尝试在 gcc bug report 数据库里进行了查找,但看起来没有人反馈过这个问题。
最后是可能的绕过方式:
- 升级 gcc 版本(gcc 8 及以上版本无此问题,7.5 及以下版本才有此问题)
- 换用其他 compiler:clang, msvc 都无此问题
- 不要用 constexpr,改用一般的 const
- 用
[&arr]显式捕获 constexpr 数组
祝读到这里的各位以后都能少踩这类奇怪的坑吧。
10 - 工具小站
参考 tools.simonwillison.net,决定把所有单页纯前端应用全部放到到一个 repo 里,并且分配一个子域名;这样不用每个小工具都申请独立 repo + 配置 Github Actions 了。
虽然目前还是没什么东西,但是还是欢迎来玩:pages.nekonull.me
11 - 基于 WebRecorder 和 MitmProxy 的图片手动抓取探索
最近收到任务,需要从某个站点下载一系列图片。首先当然是 F12 看下网络请求。这是一个无限滚动的瀑布流,图片地址本身是随机的(看起来文件名像是 uuid),所以没法直接遍历图片地址;此外每次滚动到底,都会触发一个获取下一页图片地址的请求,参数传的还是游标而不是页数,这又断绝了直接构造分页请求(例如 page=1)获取所有图片地址,再逐个拉取的念头。好在总图片数是有限的,大概在 2k 左右,每次下拉能拉回 50 条,所以手动抓取也不是不能接受。以下是两种手动抓取的思路。注:这里的手动抓取,指的是在浏览器前端通过模拟人类行为,无侵入且不对网站发起额外请求的抓取方式。
前置准备:AHK 翻页器
一个简单的小工具,每隔一段时间自动按 page down 翻页(建议提前 zoom out 调小页面比例,这样滚动起来效率更高)
AHK 翻页器代码
思路1:WebRecorder
概述:用 WebRecorder 插件,录制网络请求(WebRecorder 插件会 hook 浏览器的 XMLHttpRequest 机制),dump 出 warc (Web Archive)文件,然后再解析文件,从中提取 mime 类型为图片的文件(或者知道 URL 格式的话也可以用 URL 格式匹配)。
限制:导出的时候存在文件大小限制(Chrome 下似乎是 2G,也取决于可用内存大小),总文件大小太大的话可能会有问题。
步骤:
- 安装 Chrome 插件 Webrecorder ArchiveWeb.page
- 浏览器插件栏找到 Webrecorder,点击 Start Archiving
- 跳转到需要抓取的网页
- 打开翻页器,一直往下滚动
- 完成后打开插件,点击 Stop Archiving
- 点击插件界面内的 Home 按钮,找到刚才的 Archiving Session,点击 Download,下载一个 wacz 文件到本地
- 修改扩展名为 zip,将其中的 archive/data.warc.gz 文件解压出来,得到 data.warc 文件
- 运行如下 Python 脚本,解析 warc 文件,并从中提取图片内容
Python 解析 WARC 代码
思路2:MitmProxy
概述:安装 mitmproxy,设置浏览器代理指向 proxy,浏览时从响应中直接过滤出图片内容并保存到本地
限制:似乎没什么限制
步骤:
- 安装 mitmproxy
- 保存以下 Python 脚本为
save.py
mitmproxy save.py
- 运行 mitmproxy
- 设置浏览器,指向 mitmproxy 代理(可能你需要 proxy switchyomega)
- 跳转到需要抓取的网页,打开翻页器
- 滚动到底部,且所有图片加载完成后,需要抓取的图片应该都已经保存到本地了
12 - 如何手动 squash
最近帮解决了一个因为提交流程不规范导致的诡异 Git 分支问题,特此记录下,以备后用。
背景:主干分支 main,特性分支 feat,在特性分支上开发特性的时候,多次合入了主干分支(仅快进,没有合并冲突);模拟的 Git 历史如下图所示,其中 m* 是主干提交,f* 是特性分支提交
问题:如何把特性分支上的所有提交合并为一个提交?(类似于 squash 的 Merge 策略,但是手动做到这一点)
思路:找到主干和特性分支的第一个分叉点,以此为基准生成 patch,然后在一个新分支上 apply patch 得到一个纯净的 commit。
(非人工写作提示:以下是 LLM 根据我自己的笔记生成的内容。欢迎将反馈贴在评论区,这将决定我以后是否会更积极地使用 LLM 进行创作。)
在日常开发中,我们经常会遇到这样的问题:由于开发流程、代码审查或其他原因,特性分支(Feature Branch)和主干(Main Branch)上的提交记录混杂在一起,难以管理。为了让代码历史更为清晰、整洁,我们通常需要手动进行 squash 操作,将特性分支上的多次提交合并成一个提交点。
这篇文章将带你一步步了解如何手动进行 squash 操作,并确保不丢失任何数据。这种方法适用于已经有部分提交合并进主干,并且历史记录较为复杂的场景。
场景问题
假设你正在开发一个新功能,但在开发过程中,特性分支 feat 和主干分支 main 上的提交混杂在一起。这样一来,不仅使代码历史难以追溯,还会影响代码审查和后续维护。因此,我们希望将 feat 分支上的所有提交整合成一个提交点,并保持代码历史的清晰度。
前置准备工作
在进行操作前,我们需要做一些准备工作,确保不会出现数据丢失的风险:
创建备份分支并推送到远程: 在特性分支
feat上创建一个备份分支,并推送到远程仓库,以确保操作过程中的数据安全。这样,即使后续操作中出现意外,我们依然可以通过
feat-backup分支恢复数据。
步骤详解
1. 确定变更点
首先,我们需要找到 feat 分支和 main 分支的最后一个重合点(也就是 main 分支中包含但 feat 中不包含的最后一个提交)。这样我们就可以清晰地识别出哪些提交属于 feat,而哪些提交是混杂进来的。
如何找到变更点?
使用以下命令,找出
feat分支中第一个与main分支分叉的提交:此命令将列出
feat分支中所有提交的哈希值(commit hash),并按照时间顺序排列,其中head -n 1取出第一个分叉点的哈希值,记为{first_diverge_commit}。然后使用以下命令查找
main与feat最后一个重合点的哈希值:取命令结果的右边部分,这就是
main和feat的最后重合点,记为{last_share_commit}。
2. 计算差异(Patch)
现在我们已经知道了 main 分支和 feat 分支的分叉点和最后重合点,我们可以提取出 feat 中相对于 main 的所有变更。
使用 git diff 生成差异文件:
注意: 请将 patch 文件存放在仓库目录外,例如 ~/my_patch,因为后续执行 git reset 时会重置仓库目录内的所有文件,导致 patch 文件丢失。
3. 回溯到最后重合点
接下来,我们要将当前 feat 分支的状态回退到 main 分支的最后重合点。
该命令将 feat 分支的状态重置到 {last_share_commit} 提交。注意: reset --hard 会丢失所有当前分支的更改,因此确保之前的 patch 文件已备份。
4. 快进主干(Fast-Forward Merge)
现在,我们需要让 feat 分支快进(fast-forward)到主干 main 的最新状态。
--ff-only 参数表示如果不能进行快进合并,则不会合并。这一步确保 feat 分支的历史记录与 main 分支保持一致。
5. 应用补丁(Apply Patch)
回退和快进操作完成后,我们将 feat 分支上原本存在的所有提交变更(即 patch 文件)重新应用到当前分支。
6. 提交变更并推送
现在,我们可以创建一个新的提交,将 feat 分支的所有变更整合到一个提交中。
接着,将 feat 分支强制推送到远端,以确保远程仓库与本地分支一致:
总结
通过上述操作,我们成功地将 feat 分支的所有提交整合成了一个提交点,并且与主干保持了清晰的历史记录。完整步骤如下:
- 找出特性分支和主干的分叉点与重合点。
- 生成
patch文件保存变更。 - 回溯到重合点并进行快进合并。
- 应用
patch文件,合并所有更改。 - 提交合并后的变更,并推送到远端。
通过这种手动 squash 方法,你可以灵活地调整提交历史,确保代码库的整洁度和可读性。
勘误
- 感谢评论区 @Certseeds 的指正,第 2 步的 diff 计算指令错误地将 last_share_commit 作为了 diff 开始点,实际上应该为 main(主干分支);原文已修复。
13 - 在 Devtools 里触发前端组件的内部状态更新
这个标题大概不太好理解;以下是对我遇到的问题,及我的解决方案的描述,在获得了相关上下文后,这个标题可能会稍微好理解一些。
背景:在我的工作中,时常需要使用一个内部的日志查询平台。在使用时,需要先指定日志的开始和结束时间,默认情况下开始时间会被设置为今日的0点,结束时间则被设置为今日的23:59:59。虽然大部分情况下默认值都足够了,但是有时我需要调整时间范围,例如,选择为昨天,或是选择为某个 unix timestamp / yyyy-MM-dd hh-mm-ss 的前后一分钟。但无论是从界面上选择日期,还是手动输入时间都有些麻烦。我想半自动化这一过程,例如写一些 userscript 来改善时间范围的选择体验。
问题:我需要在无法接触/修改前端源代码的情况下,用 js 修改这个日期选择器的值。
从类名中不难发现,这个日期时间选择器底层实际上就是 Element UI 的 DateTimePicker。然而如果直接修改对应的 input 的 value,并不能满足要求,因为这只修改了表现层的输出,Vue 组件中的内部状态实际上没有更新(也可以从点击查询按钮后发出的网络请求中验证)。正确的做法是用 js 在对应的元素上触发合适的事件,让组件像处理用户输入那样处理我们的请求。那应该触发怎样的事件呢?
有几个思路可以找到对应的事件:
- 使用 Chrome Devtools 自带的 monitorEvents :首先用右键-审查元素在 DOM 树中定位到 input,然后右键"存储为全局变量",会保存到
temp1,再在控制台输入monitorEvents(temp1)就可以观察到该元素上的所有事件了。然后像正常使用一样操作下选择器,可以看到触发的事件和参数。(mouse 相关事件会有很多坐标更新,杂音比较大) - 打开 Github 找到这个组件对应的源码,相关的
@input/@change等方法也能说明该组件会处理的事件类型
但作为现代开发者,首先当然还是先问问 GPT 了;GPT 给了一个看起来很靠谱的 script,节选如下。其中基本把组件可能处理的事件都触发了一次。
这个 script 在官网的 demo 上的确可以用,但是很不幸在我的内部工具页面上并不行,会出现一个奇怪的 Uncaught TypeError: Cannot read properties of undefined 错误,点击调用栈的话只有 minified 的代码,完全看不出来是什么问题。到这里似乎陷入了僵局。然而进一步的实验发现,似乎这个问题只会在页面首次使用的时候出现;如果我手动先选择过一次日期时间,再用这个脚本就可以设置了。看了下组件源码,注意到组件在更新内部状态时,还会同步去更新 picker(弹出的日期弹框)里的值,是否可能是这个问题?有了这个模糊的思路之后,我再次开着 devtools 开始验证我的猜想。页面首次加载之后,DOM 树中并没有 picker 对应的节点,此时用脚本设置会失败;然而手动操作时,picker 节点会被创建,设置完成后被隐藏(但依然在 DOM 树中);再次运行脚本,设置日期时间值成功了。看来的确是 picker 在脚本运行时没有正确被初始化导致的。
下一步就清晰一些了,只需要想办法在脚本操作之前,保证 picker 已经被初始化就好了;继续尝试了源码里的各种事件,最终发现可以用 focus 事件触发 picker 创建,用 Esc 可以让 picker 消失。(这一步其实试了很久,而且中间有几次把 bubbles 写成了 bubble 导致一直触发不成功)
最后得到的可以正常工作的脚本如下。虽然很丑陋,但是至少能用了…
14 - Obsidian 与工作日志
虽然从开始工作到现在已经有两年多了,但大部分时间里我需要同时跟进的事项并没有那么多,复杂度也没有太高,基本上不需要太多记录就可以完成。但是最近几个月以来,手头工作的数量和复杂度都急剧上升,完全依靠大脑跟进已经逐渐不可能了。在此背景下,我开始尝试用 Obsidian 搭建自己的工作日志系统,也读到了其他人的一些分享(如 Use A Work Journal To Recover Focus Faster And Clarify Your Thoughts)。目前我的工作日志系统已经正常运转大概三个月了,大部分坑都已经填平,也成为了我工作中不可或缺的一个部分。以下是我自己目前的一些经验,希望分享出来能帮到各位读者。
工作日志能解决的问题
- 在多个任务间切换而不丢失信息:随着跟进任务数量的增加,将所有任务相关的信息记忆在大脑里越来越困难,然后会发现越来越多的时间被花费在信息寻找上:这个任务的代码在哪个分支上?我今天要交付的文件应该找谁要?这个项目的最新结论是上次谁在哪个群拍的板?有了工作日志之后,每个任务都有自己独立的条目,只要找到它,相关信息就能立刻获得。
- 记录每一步尝试:有些时候第一次尝试就能成功,但更多时候并非如此。通常需要很多次修改、调试和观察,才能确认自己是否在正确的方向上前进。最终提交的代码或文件只反映了最后成功的结果,中间的探索过程却完全丢失了。有了工作日志之后,一切中间过程都能被记录和回溯。
- 快速复用SOP以保证关键任务的可重现性:探索性的任务很有趣,但也有一部分任务是事务性的:目标明确,步骤清晰,也做过很多次了;但是步骤数量增加和操作过程的复杂度提升,都会让某一步骤遗忘/未能按照预期完成的概率增加;工作日志让维护和应用SOP(Standard Operation Procedure,标准操作流程)更简单,只要每次遵循就能避免出错。(当然更好的选择是完全将事务性工作自动化,让人不用参与,然而这并非总是可行/经济)
- 阶段性总结时有话可说:在大厂打工,
(周|月|季|半年|年)报难以避免,然而很多工作都很琐碎,一个周期过去了可能发现自己甚至说不出来做了什么;工作日志让回溯历史更加简单,避免了无话可说的窘境。
我如何使用工作日志
什么任务需要建立工作日志
目前我的标准是预估完成时间,超过 5 分钟的任务就值得建立一条工作日志了。在我目前的工作流中,我通常会在一个 4K 分辨率的屏幕上操作,左侧 70% 是我当前的核心工作区(如浏览器/代码编辑器),右侧会开三个窗口,从上到下分别是 Apple Notes(临时任务列表)、CudaText(草稿纸/scratchpad)、Obsidian(工作日志)。当我收到一个任务(可能是电话/IM消息/当面通知)后,我会先判断该事项完成所需的时间;如果预估可以在 5 分钟内完成(简单的配置修改/信息收集表填写/告警单处理),那就会放在 Apple Notes 里作为一个新的待办项;如果预估需要 5 分钟或者更长(bug 调查/开发需求),那就在 Obsidian 里创建一个工作日志条目文件。当然预估的时间可能不准,如果实际开始做的时候发现比我预估的时间更长,我也会把这个任务从 Apple Notes 的代办项提升为一个 Obsidian 日志。
工作日志模板
之前我是的每个工作日志都是从零开始,然而随着日志的逐渐增加,我观察到自己在每个日志初始时写下的信息有共同之处,于是从中提取建立了模板。目前我使用的模板很简单,只是有一个 Markdown 表格,描述了这个任务的常用关键信息,其中包含以下的 key:
- 对接人:通常是将任务分配给我的人,或者是某个项目的交付负责人
- 群:我所在的公司使用企业微信作为 IM,通常每个项目有自己的群,其中包含了这个项目的所有参与人和关键信息;如果你所在的公司使用其他的 IM,可以替换为类似的“沟通点”概念(如 Slack 中的频道)
- 需求链接:任务在到内部需求系统的链接,通常包含正式的需求标题
- MR链接:到代码库 Merge Request 的链接(提交MR后才会填写此部分);主要用于回溯时快速找到相关的代码变更
- 其他链接:其他和此任务相关的链接,例如在线文档、内部的 Wiki 页面、配置系统地址
- 预期交付时间:该任务的预计完成时间,用于决定优先级
- 共识/结论:一个任务可能会跨越较长的时间,而其中结论可能时刻变更。我通常在这个字段中以时间倒叙记录最新结论(日期-人-结论)
- 代码分支:如果这是个开发任务,相关的代码变更在哪个分支上
- 涉及模块:如果这是个开发任务,需要开发/测试/部署的模块列表
使用工作日志
从模板建立工作日志并填充基本信息后,这个工作日志就可以使用了。
- 不限定记录内容:对于工作日志中记录的内容,我并没有做限定,而是基本想到什么/用到什么/看到什么都会记录进去,例如调试时的 trace id,自己的猜想和验证结果,模块/方法的调用链,可以参考的代码段,群聊中重要信息等等。
- 自己QA:另一个常见的做法是自己给自己提问,通常是写下一连串问题(Q:为什么这个bug在case1的情况下不会触发?),然后通过一系列探索填充答案(A:因为外部的检查提前失败报错了)(基本上把自己当作一个 LLM 来用)
- 每天分割:对于一个持续时间较长的任务,工作日志可能也会变得逐渐混乱起来;我自己的做法是用
---分割每天的记录,并在开头标记日期。 - 从 SOP 复制:如果这是个事务性任务,而且此前已经有 SOP,则可以直接复制 SOP(例如 checklist),以便完整并正确地重新完成任务。(注意:最好不要直接从历史日志复制,一来这揭示了你可能需要一个SOP,那就应该去正式建立一个;二来历史日志中可能存在干扰细节,例如需要每次生成的ID,直接复制可能让你出错)
特殊文件
除了每个任务特定的日志之外,我还维护了一些特殊文件,每个都有自己的特定用途。
- SOPs:当我发现我在重复历史任务时,就会提取出一个SOP,其中是整理过可以直接复制到新日志中的内容;通常包含任务描述,前置条件,步骤的checklist、每个步骤需要的信息(如配置系统链接)
- weekly:用于组会的事项列表。我所在的小组的组会是周五下午;通常我会在周五上午填写本周已完成的事项,以及下一周将要启动的事项,这样组会上就不用临时寻找了。
- lowlights:可改进的项目集合。通常会在遇到一个让我不爽的事情(如某个内部工具不好用)时快速记录,组会前再填写到专用的复盘文档。
- hacks:用来记录一些偶尔遇到但是每次想不起来怎么做的事情的操作说明。
相关的 Obsidian 插件
虽然工作日志的存在本身就是有意义的,但是和一些 Obsidian 插件配合可以更方便。
- Tasks:一个 Obsidian 体系下很强大的任务管理插件。我一般的用法比较简单,每个工作日志开头会有一个 Markdown TODO 项目(
- [ ]开头),Tasks 插件会将所有这类任务收集起来,呈现在一个统一的视图中;这样我只需要看这个视图,就能定位到还有哪些未完成的任务,并快速跳转到相关的笔记了 - Unique Note Creator(时间戳笔记生成器):在侧边栏添加一个按钮,点击时套用模板,创建一个带有当前时间戳的新笔记。目前我创建工作日志的主要方式。
- Another Quick Switcher:在快速切换选择器中,让搜索结果以修改时间逆序排列(原生的 Quick Switch 并非如此),避免切换到非预期的很久之前的笔记中
- Scroll To Top:在笔记右下角增加按钮,可以快速跳转到笔记开头或者结尾;对于很长的笔记比较有用
暂未解决的问题
最后是一些我目前还没有完全解决的问题,如果有思路欢迎分享。
- 粘贴长代码时折叠不便:虽然 Obsidian 有自带的折叠机制,但是用在代码上总感觉不太方便;用于列表/标题的 Folding 会导致文件增加不需要的结构;Callout 因为属于引用,粘贴代码的时候需要一些特殊处理才能让代码段正确放进去。希望能找到一个更接近 Github Markdown 预览中类似于
<summary>的方案。 - 切换到其他文件时丢失阅读进度:如果关闭了某个笔记 tab,下次重新打开的时候,默认会回到文件开头而不是上次阅读/编辑的位置。尝试了几个社区插件但是效果不佳。
- 命名问题:同一个任务可能有多种描述,然而如果关键字不在标题里就搜不到;现在我的做法是把任务所有的关键字都扔在标题里(类似于 SEO),虽然看起来不太美观但是搜起来很好用。一个改进方向可能是自定义搜索,让某个关键词可以匹配多个同义的关键词?
15 - 读书记录《时间贫困》
书名:《时间贫困》
评价:7/10;很短的书,快的话一小时就能读完;了解到了一些和自己认知之外但符合自己真实感受的观点(e.g. 完全躺平未必会快乐);可能会试试书中描述的行动。
版本:微信读书
观点
- 可支配时间长!=幸福:可支配时间太少(如每天少于2小时)会带来压力,从而降低幸福感;可支配时间太多(如每天超过5小时)会让人缺乏目标感,从而降低幸福感;排除时间太少和太多的极端情况,幸福与你所拥有的可支配时间的长短无关,而是取决于你如何利用自己拥有的时间。
- 时间充裕与否会影响自信: 时间很多时,我们倾向于积极聚焦。时间充裕总体上会提升我们的信心,让我们对有信心实现的一切感到乐观而兴奋。只要有足够的时间,我们将前途无量。但在时间有限时(现实往往如此),我们就会悲观地倾向于预防聚焦。当所剩时间不多时,我们满脑子都是失败的可能性,从而会降低目标来匹配不足的信心。深陷时间贫困时,我们只是在勉强度日。
- 更自信的人认为自己也拥有更多时间:当人们感受到更强的自我效能感时,他们也会认为自己拥有更多时间。这一发现意义重大,因为它意味着你可以有意识且有效地操纵你的时间宽裕度。通过采取一些手段增强你的自信心,你就会大大缓解时间贫困的困境。
- 快乐不意味着远离工作:快乐并不意味着要远离工作,因为(正如我们所知)工作是有意义的。关键在于,对时间的思考会促使我们把时间花在那些能带来个人成就感的活动上。我在那些认为工作有意义的人中重新进行了第一项研究,结果证明对时间的思考激励着他们在工作中做得更多。
- 亲密关系是快乐的必要条件:这一重要的数据表明,尽管没有一个变量是快乐的充分条件,但亲密关系是快乐的必要条件。换句话说,有朋友并不能百分之百保证你会快乐,但要想变得快乐,你需要朋友。 只有当我们有了归属感(爱与被爱),追求个人成就和自我实现所付出的个人努力才是值得的。如果你想攀登事业的阶梯,这很好,但前提是不要为此牺牲你与生活中所有人的联系。如果你到达顶峰时没有人和你一起庆祝,那么你也不会有多大的成就感。
- 花钱买时间可能是有意义的:有研究确实警示我们,与购买更好的体验相比,购买物品带来的快乐感明显更少且不持久。此外,阿什利团队的分析结果表明,外包家务带来的积极影响并不取决于收入水平。花钱买时间可以使大多数人受益。无论你有多少钱,时间对每个人来说都一样宝贵。 如果你花点儿钱来给自己腾出一些时间,你就可以用这些时间去做对你来说真正重要的事情了。你可以更有效地使用买来的时间,把它们花在那些更快乐、更有意义的活动上。
- 户外让人更快乐:有无数个例子证明:人们在户外更快乐。此外,这种快乐程度的提升并不取决于天气(尽管人们在阳光明媚的温暖天气中的确更快乐)、他们正在做的事(尽管有些特别快乐的活动只能在户外进行,如打理花园或赏鸟)或环境(尽管人们在大自然或绿色空间中比在城市更快乐),而是只需要到户外即可
- 价值观+优势+爱好=更满意的工作时间:越来越多的证据表明,即使你从事的工作并不完美(实际上,没有一份工作是完美的),但如果你将工作同你的价值观(你在意的事物)、你的优势(你擅长的事物)以及你的爱好(你喜欢的事物)结合起来,你就会更有动力,在工作上也会表现得更加出色,对工作和生活的总体满意度也会提高
- 工作场所也能交朋友:如果你在工作时间内开展一些真实的人际交往活动,你的工作时间会变得更快乐、更有意义。花时间在工作中结交朋友是值得的。我们清醒的大部分时间都在办公室度过,如果把这些时间都花在痛苦的工作上,那就是一种浪费。你必须摒弃这样一种观念:在工作场合中不能展现出真实的自我。 如果办公室有个你想见的人,那么你就会有上班的动力,这个人也会帮助你在工作时间获得更多的快乐和成就感。
- 不同年龄对平凡快乐的感知不同:对年轻人来说,不平凡的经历比平凡的经历更让他们感到快乐;而对年长者来说,平凡的经历给他们带来的快乐不亚于不平凡的经历。换句话说,从统计学上来看,年长者从平凡的经历和不平凡的经历中获得的快乐几乎一样多。 随着年龄的增长,人们从平凡的经历中获得的快乐会越来越多,自然而然也会意识到自己所剩的生命是有限的。当人们意识到自己的时间宝贵时,就会更享受简单时刻的快乐。这些结果表明,尽管我比阿米特大不了多少,但我正在迈向人生的下一个阶段。这也就解释了我和阿米特的快乐周末为何不同。
- 快乐时间是有限的:一旦你认识到剩下的时间是有限的,你在这段时间里会更快乐。虽然在注意到时间如此有限后,你可能会感到不安,但你会更加关注并更容易发现那些简单的快乐。认识到“快乐的时光是短暂的”不仅有助于你度过艰难时期,还会提醒你停下脚步,这样你就不会错过一路上的美好。
- 应该优先考虑带给你快乐的事:研究者阿纳·凯南和拉恩·基维茨也观察到这个现象。他们巧妙地称其为“远视现象”,即一种过于有远见的、只选未来不顾现在的倾向。这是过度自控的问题。他们指出,把苹果当零食确实比巧克力蛋糕更健康,但倘若每次都选苹果,你就永远尝不到美味的巧克力了。如果总是选择“该做之事”而非“想做之事”,你就永远不会有享受的机会。年复一年,你只干正事,但回首往事时,你可能会因为错过了生活中应有的快乐而感到非常遗憾,比如白亚麻餐布上的羊角面包。 所以,在有限的时间里,确定、承诺并优先安排能带给你快乐的活动。
- 拆分喜欢的活动以避免享乐适应:随着时间的推移,我们会习惯现有事物,所以我们在一项活动开始时会特别敏感。这是我们最专注的时候,体验也最为强烈。因此,为了利用享乐适应,你应该把你喜欢的活动拆分开——创造更多开始,防止厌倦滋生。美好事物的延续也会带给你更多期待。
行动
- 时间追踪:记录自己的时间分配和快乐程度,找出快乐和不快乐的活动中存在的共同点
- 计算剩余时间:计算一下涉及其他人的活动中,将来可能做这项活动的大概次数,也就是他们还剩下多少次机会,以及现在已经用尽了多少比例的机会
- 每周留出独处和思考的一小时:舒式一小时比起之前提过的消除干扰所带来的快乐更有意义。正是在这样一段时间里,你可以更深入地处理问题、更恣意地创新、更有效地制定战略,以应对需要关注的重要决策
16 - 读书记录《软件设计的哲学(第2版)》
书名:A Philosophy of Software Design (2nd Edition)
评价:8.5/10;一开始是看到封面感觉很棒,于是就找来读了下;不是很长,三四个小时就能读完;虽然内容比较基本,但是能系统化的重新复习下也挺好的
版本:anna’s archive,llm翻译为中文
- 软件设计的原则
- 复杂性的管理
- 复杂性源自依赖和晦涩的累积;随着复杂性增加,它导致变更放大、高认知负荷以及未知的未知因素
- 变更放大:一个看似简单的改动需要在多处修改代码
- 认知负荷:为了进行更改,开发者必须积累大量信息。
- 未知的未知:尚不清楚需要修改哪些代码,或者为了进行这些修改必须考虑哪些信息。
- 因此,实现每个新功能需要更多的代码修改。此外,开发人员花费更多时间获取足够的信息以安全地进行更改,在最糟糕的情况下,他们甚至无法找到所需的所有信息。底线是,复杂性使得修改现有代码库变得困难且充满风险。
- 向下转移复杂性最有意义的情况是:(a)被转移的复杂性与类的现有功能紧密相关,(b)转移复杂性将导致应用程序其他部分的简化,以及(c)转移复杂性简化了类的接口。记住,目标是最小化整个系统的复杂性。
- 复杂性源自依赖和晦涩的累积;随着复杂性增加,它导致变更放大、高认知负荷以及未知的未知因素
- 模块化与接口设计
- 在设计类和其他模块时,最重要的议题是使它们具有深度,以便为常见用例提供简单的接口,同时仍能提供重要的功能。
- 在将系统分解为模块时,尽量避免受到运行时操作顺序的影响;这会导致时间分解,从而引发信息泄露和浅层模块。
- 软件设计中最关键的要素之一就是确定谁需要知道什么,以及何时需要知道。当细节至关重要时,最好将它们明确且尽可能显而易见地展现出来
- 多个方法可以拥有相同的签名,只要它们各自提供有用且独特的功能。
- 代码简化与重构
- 在编写详细代码时,简化代码最有效的方法之一是消除特殊情况
- 特殊情况可能导致代码充斥着if语句,这使得代码难以理解且容易产生错误。因此,应尽可能消除特殊情况。最佳的做法是通过设计正常情况,使其自动处理边缘条件,而无需额外代码。
- 如果你为了减少方法数量而不得不引入大量额外参数,那么你可能并没有真正简化问题
- 复杂性的管理
- 从基础开始
- 变量与方法的命名规范
- 因此,你不应满足于仅仅是“合理接近”的命名。花一些额外的时间来挑选精确、无歧义且直观的优秀名称。这份额外的关注将很快得到回报,随着时间的推移,你将学会迅速选择好的名称。
- 名称“cursorVisible”传达了更多信息;例如,它让读者能够猜测真值的含义(通常情况下,布尔变量的名称应始终为谓词形式)。名称中不再包含“blink”一词,因此如果读者想知道为什么光标并非始终可见,他们需要查阅文档;这部分信息相对不那么重要。
- 如果你发现很难为一个特定变量想出一个既精确、直观又不太长的名字,这是一个警示信号。这表明该变量可能没有明确的定义或目的。当这种情况发生时,考虑采用其他分解方法。例如,也许你试图用一个单一变量来表示多个事物;如果是这样,将表示分解为多个变量可能会使每个变量的定义更简单。选择好名字的过程可以发现设计中的弱点,从而改进你的设计。
- 名称中的每个单词都应提供有用信息;那些无助于阐明变量含义的词汇只会增加冗余(例如,它们可能导致更多行换行)。一个常见的错误是在名称中添加诸如“field”或“object”之类的通用名词,比如“fileObject”。在这种情况下,“Object”这个词很可能并未提供有用信息(是否存在不是对象的文件?),因此应从名称中省略。
- 杰兰德的一个观点我深表赞同:“一个名称的声明与其使用之间的距离越远,该名称就应该越长。”之前关于使用名为i和j的循环变量的讨论,正是这一规则的例证。
- 代码结构的清晰性与可读性
- 仅凭方法的长度本身很少是拆分方法的充分理由。通常情况下,开发者倾向于过度拆分方法。拆分方法会引入额外的接口,增加了复杂性。同时,它将原方法的各个部分分离,如果这些部分实际上是相关的,这会使代码更难以阅读。除非拆分方法能使整个系统变得更简单,否则不应进行拆分
- 长方法并不总是坏事。例如,假设一个方法包含五个20行代码的块,这些块按顺序执行。如果这些块相对独立,那么方法可以逐块阅读和理解;将每个块移到单独的方法中并没有太大好处。如果这些块之间有复杂的交互,那么将它们放在一起就更为重要,以便读者可以一次性看到所有代码;如果每个块都在单独的方法中,读者将不得不在这些分散的方法之间来回翻阅,以理解它们是如何协同工作的。包含数百行代码的方法如果具有简单的签名并且易于阅读,那么它们也是很好的。这些方法是深层的(功能丰富,接口简单),这是好事
- 深度比长度更重要:首先确保函数有足够的深度,然后再尝试使其足够短以便轻松阅读。不要为了长度牺牲深度。决定拆分或合并模块应基于复杂度。选择能实现最佳信息隐藏、最少依赖关系及最深接口的结构。
- 注释的重要性与编写技巧
- 优质的注释能显著提升软件的整体质量;编写优质注释并不难;而且(这可能难以置信)编写注释实际上可以很有趣。
- 注释通过提供不同层次的详细信息来增强代码。有些注释提供比代码更低的、更详细的层次信息;这些注释通过阐明代码的确切含义来增加精确性。其他注释提供比代码更高的、更抽象的层次信息;这些注释提供直觉,比如代码背后的推理,或者一种更简单、更抽象的思考代码的方式。与代码处于同一层次的注释很可能会重复代码的内容。
- 具体的注释方式
- 在注释类实例变量、方法参数和返回值时,精确性尤为重要。变量声明中的名称和类型通常不够精确。注释可以填补缺失的细节,例如:
- 这个变量的单位是什么?
- 边界条件是包含性的还是排他性的?
- 如果允许空值,这暗示着什么?
- 如果一个变量指向一个最终必须被释放或关闭的资源,那么谁负责释放或关闭它?
- 是否存在某些特性(不变量),对于变量而言总是成立,例如“这个列表始终至少包含一个条目”?
- 在记录变量时,应考虑名词而非动词。换言之,重点在于变量所代表的内容,而非其如何被操作。
- 在记录一个方法时,描述该方法最可能被调用的条件(特别是在方法仅在特殊情况下被调用时)会非常有帮助。
- 记录抽象的第一步是将接口注释与实现注释分开。接口注释提供了某人为了使用类或方法所需了解的信息;它们定义了抽象。实现注释描述了类或方法内部如何工作以实现抽象。将这两种注释分开很重要,这样接口的用户就不会接触到实现细节。
- 方法接口注释既包含高层次的抽象信息,也包含低层次的精确细节
- 注释通常以一两句话开始,描述调用者感知到的方法行为;这是更高层次的抽象。评论必须详细描述每个参数及其返回值(如有)。
- 这些评论必须非常精确,并且必须描述参数值的任何限制以及参数之间的依赖关系。
- 如果方法有任何副作用,这些必须在接口注释中记录。副作用是指方法对系统未来行为产生影响的任何后果,但不是结果的一部分。例如,如果方法向内部数据结构添加一个值,该值可以通过未来的方法调用检索,这就是副作用;写入文件系统也是副作用。
- 方法的接口注释必须描述该方法可能抛出的任何异常。
- 如果在一个方法被调用之前必须满足某些先决条件,这些条件必须被描述出来(可能需要先调用其他方法;对于二分查找方法,被查找的列表必须是已排序的)。尽量减少先决条件是一个好主意,但任何保留的先决条件都必须有文档说明。
- 在注释类实例变量、方法参数和返回值时,精确性尤为重要。变量声明中的名称和类型通常不够精确。注释可以填补缺失的细节,例如:
- 幸运的是,有一个明显的地方是开发者在添加新状态值时必须去的,那就是状态枚举的声明处。我们利用这一点,在那个枚举中添加了注释,指出了所有也必须修改的其他地方
- 处理跨模块注释:我最近在尝试一种方法,即跨模块问题记录在一个名为designNotes的中央文件中。该文件被清晰地划分为多个标有明确标签的部分,每个部分对应一个主要主题。
- 在遵循注释应描述代码中不明显内容的规则时,“明显”是从初次阅读代码的人(而非你本人)的角度出发的。撰写注释时,尝试站在读者的立场,思考他们需要了解的关键信息是什么。如果你的代码正在接受审查,而审查者指出某些内容不明显,不要与他们争论;如果读者认为某处不明显,那么它就是不明显。与其争论,不如尝试理解他们感到困惑的地方,并思考是否能通过更清晰的注释或更优化的代码来阐明。
- 一般来说,注释与它所描述的代码之间的距离越远,它就应该越抽象(这样可以降低因代码变动而导致注释失效的可能性)。
- 在撰写提交信息时,问问自己:未来开发者是否需要这些信息?如果是,那么请在代码中记录下来。例如,一个描述了促使代码变更的微妙问题的提交信息。如果这未在代码中记录,那么后续开发者可能会在不知情的情况下撤销该变更,从而重新引入一个错误。如果你想在提交信息中也包含这份信息的副本,那当然可以,但最重要的是将其记录在代码中。这体现了将文档置于开发者最可能看到的地方的原则;而提交日志通常并非这样的场所。
- 保持注释最新性的第二种技巧是避免重复。如果文档被复制,开发者找到并更新所有相关副本的难度就会增加。相反,尝试对每个设计决策只记录一次。如果代码中多个地方受到某个特定决策的影响,不要在这些点重复文档。而是找到最显眼的单一位置放置文档。例如,假设某个变量的行为复杂,影响到该变量使用的多个不同地方。你可以在变量声明旁边的注释中记录这种行为。这是一个自然的位置,开发者在理解使用该变量的代码遇到困难时很可能会查看。
- 对于更局部化的约定,例如不变量,找到代码中合适的位置来记录它们。如果你不将这些约定写下来,其他人很可能不会遵循它们。
- 何时测试
- 测试,尤其是单元测试,在软件设计中扮演着重要角色,因为它们促进了重构。没有测试套件,对系统进行重大结构改动是危险的。没有简单的方法来发现错误,因此错误很可能会在新代码部署后才被发现,那时发现和修复错误的成本要高得多。因此,在没有良好测试套件的系统中,开发者会避免重构;他们试图为每个新功能或错误修复最小化代码更改的数量,这意味着复杂性积累,设计错误得不到纠正。有了良好的测试集,开发者在重构时可以更有信心,因为测试套件会发现大多数引入的错误。这鼓励开发者对系统进行结构上的改进,从而得到更好的设计。
- 测试驱动开发的问题在于,它将注意力集中在使特定功能正常工作上,而不是寻找最佳设计。这纯粹是战术编程,带有其所有的不利之处。测试驱动开发过于渐进:在任何时候,都很容易为了通过下一个测试而匆匆添加下一个功能。没有明显的时间进行设计,因此很容易陷入混乱
- 在修复 bug 时,先编写测试是一个合理的做法。在修复 bug 之前,先写一个因为该 bug 而失败的单元测试。然后修复 bug,并确保单元测试现在通过。这是确保你真正修复了 bug 的最佳方法。如果你在编写测试之前就修复了bug,那么新的单元测试可能实际上并未触发该 bug,这种情况下它将无法告诉你是否真正解决了问题。
- 设计模式的应用
- 不要试图将问题强行套入某个设计模式,而应采用更简洁的自定义方法。使用设计模式并不意味着自动提升软件系统的质量;只有当设计模式恰到好处时,才能发挥其优势。
- 每当你遇到一个新的软件开发范式的提议时,从复杂性的角度对其进行质疑:这个提议是否真的有助于减少大型软件系统的复杂性?许多提议表面上听起来不错,但如果你深入探究,你会发现其中一些实际上使复杂性变得更糟,而非更好。
- 变量与方法的命名规范
- 具体做法
- 设计两次
- 我注意到,“设计两次”原则有时对非常聪明的人难以接受。在他们成长的过程中,聪明人发现他们对任何问题的第一个快速想法就足以获得好成绩;没有必要考虑第二个或第三个可能性。这往往导致不良的工作习惯。然而,随着这些人年龄的增长,他们被提拔到面临越来越困难问题的环境中。最终,每个人都会达到一个阶段,即你的第一个想法不再足够好;如果你想取得真正出色的成果,无论你多么聪明,你都必须考虑第二个可能性,甚至可能是第三个。大型软件系统的设计就属于这一类:没有人能够一次就做得完美。
- 注释先行的开发
- 最佳的注释编写时机是在过程的开始,即编写代码的同时。先编写注释使得文档成为设计过程的一部分。这不仅能产生更好的文档,还能带来更优秀的设计,并且使编写文档的过程更加愉快。
- 先写注释意味着在开始编码前,抽象概念会更加稳定。这很可能会在编码过程中节省时间。相反,如果先写代码,抽象概念可能会随着编码的进行而演变,这需要比先写注释的方法更多的代码修订。综合考虑这些因素,整体上先写注释可能会更快。
- 对于一个新类,我首先撰写类接口注释。
- 接下来,我会为最重要的公共方法编写接口注释和签名,但我会让方法体保持空白。
- 我稍微反复斟酌这些评论,直到基本结构感觉差不多合适。
- 在此,我为类中最重要的实例变量撰写声明和注释。
- 最后,我填充了方法的主体,并在必要时添加了实现注释。
- 在编写方法体时,我通常会发现需要额外的属性和实例变量。对于每个新写的方法,我会在方法体之前先写接口注释;对于实例变量,我会在写变量声明的同时填写注释。
- 当代码完成时,注释也已完成。从未有过未编写的注释积压。
- 性能优化与重构
- 一旦你对什么是昂贵、什么是便宜有了大致的了解,你就可以利用这些信息尽可能选择便宜的操作。在很多情况下,更高效的方法可能和较慢的方法一样简单。
- 再举一个例子,考虑在C或C++这样的语言中分配一个结构体数组。有两种方法可以实现这一点。一种方法是将数组用于保存指向结构体的指针,在这种情况下,你必须首先为数组分配空间,然后为每个单独的结构体分配空间。将结构体直接存储在数组中要高效得多,这样你只需为所有内容分配一个大的内存块。
- 一般来说,代码越简单,运行速度往往越快。如果你已经定义并处理了特殊情况和异常,那么就不需要额外的代码来检查这些情况,系统运行速度自然更快。深层类比浅层类更高效,因为每次方法调用它们能完成更多工作。浅层类会导致更多的层级跨越,而每次层级跨越都会增加开销。
- 在进行任何更改之前,应测量系统的现有行为。这有两个目的。首先,这些测量将确定性能调优影响最大的地方。仅仅测量顶层系统性能是不够的。这可能告诉你系统太慢,但不会告诉你原因。你需要更深入地测量,以详细识别影响整体性能的因素;目标是找出系统当前花费大量时间的少数特定位置,并且你有改进的想法。测量的第二个目的是提供一个基准,这样你可以在更改后重新测量性能,以确保性能确实得到了提升。如果更改没有使性能产生可测量的差异,那么就撤销这些更改(除非它们使系统更简单)。除非能显著加快系统速度,否则保留复杂性是没有意义的。
- 改进其性能的最佳方法是进行“根本性”的改变,比如引入缓存,或者采用不同的算法方法(例如平衡树与列表)。
- 首先,问问自己,在常见情况下,为了完成所需任务,必须执行的最少代码量是多少。忽略任何现有的代码结构。想象一下,你正在编写一个新方法,只实现关键路径,即在大多数常见情况下必须执行的最少代码量。当前的代码可能充斥着特殊情况;在这个练习中忽略它们。当前的代码可能在关键路径上经过多个方法调用;想象一下,你可以将所有相关代码放在一个方法中。当前的代码也可能使用多种变量和数据结构;只考虑关键路径所需的数据,并假设任何数据结构对关键路径最为方便。例如,将多个变量合并为一个值可能是有意义的。假设你可以完全重新设计系统,以最小化关键路径必须执行的代码量。我们称这种代码为“理想状态”。
- 在为性能进行重构时,应尽量减少必须检查的特殊情况数量。理想情况下,开始处应只有一个if语句,通过一次测试就能检测所有特殊情况。在正常情况下,只需进行这一次测试,之后关键路径即可无须额外特殊情况测试地执行。如果初始测试未通过(意味着出现了特殊情况),代码可以跳转到关键路径之外的独立位置处理该情况。
- 清晰的设计与高性能是可以兼容的。Buffer类的重写不仅使其性能提升了两倍,同时简化了设计并减少了20%的代码量。复杂的代码往往运行缓慢,因为它执行了多余或重复的工作。相反,如果你编写清晰、简洁的代码,你的系统很可能已经足够快速,以至于你无需过多担心性能问题。在少数确实需要优化性能的情况下,关键仍然是简洁性:找出对性能至关重要的关键路径,并尽可能简化它们。
- 遵守约定和惯例
- 一旦发现任何看似约定的做法,就应遵循。在进行设计决策时,问问自己这个决策是否可能在项目的其他地方也有类似的选择;如果有,找到一个现成的例子,并在你的新代码中采用相同的方法。
- 不要改变现有的惯例。抵制那种想要“改进”现有惯例的冲动。拥有一个“更好的想法”并不是引入不一致性的充分理由。你的新想法可能确实更好,但一致性相对于不一致性的价值几乎总是大于一种方法相对于另一种方法的价值。在引入不一致行为之前,问自己两个问题。首先,你是否拥有重要的新信息来证明你的方法,而这些信息在旧惯例建立时是不可用的?其次,新方法是否好到值得花时间去更新所有旧的使用?如果你的组织同意这两个问题的答案都是“是”,那么就大胆进行升级;完成后,旧惯例的痕迹应该荡然无存。然而,你仍然面临风险,即其他开发者可能不知道新惯例,因此他们未来可能会重新引入旧方法。总的来说,重新考虑已建立的惯例很少是开发者时间的良好利用。
- “显而易见”存在于读者心中:注意到他人代码的不明显之处比发现自己的代码问题要容易得多。因此,判断代码是否显而易见的最佳方法是通过代码审查。如果有人阅读你的代码后认为它不明显,那么它就是不明显的,无论对你来说它看起来多么清晰。通过努力理解是什么使得代码不明显,你将学会如何在将来编写更好的代码。
- 代码如果符合读者预期的惯例,则最为直观;如果不符合,那么记录这种行为就很重要,以免读者感到困惑。
- 为了使代码显而易见,你必须确保读者始终拥有理解代码所需的信息。你可以通过三种方式来实现这一点。最佳方法是减少所需的信息量,运用抽象和消除特殊情况等设计技巧。其次,你可以利用读者在其他情境中已获得的信息(例如,通过遵循惯例和符合预期),这样读者就不必为你的代码学习新信息。第三,你可以通过使用良好的命名和策略性注释等技巧,在代码中向他们展示重要信息。
- 正确对待事件驱动编程
- 事件驱动编程使得跟踪控制流程变得困难。事件处理函数从未被直接调用;它们是通过事件模块间接调用的,通常使用函数指针或接口。即使你在事件模块中找到了调用点,仍然无法确定具体会调用哪个函数:这取决于运行时注册了哪些处理程序。因此,很难对事件驱动代码进行推理,或者确信其工作正常。
- 为了弥补这种晦涩,请在每个处理函数接口注释中指明其何时被调用
- 避免使用通用容器
- 不幸的是,通用容器导致代码不直观,因为被分组的元素具有模糊其含义的通用名称。在上述示例中,调用者必须使用result.getKey()和result.getValue()来引用两个返回值,这无法提供关于值实际含义的任何线索。
- 因此,最好不要使用通用容器。如果你需要一个容器,可以定义一个专门针对特定用途的新类或结构。这样,你就可以为元素使用有意义的名称,并在声明中提供额外的文档,这是通用容器无法做到的。
- 透传变量与上下文
- 透传变量增加了复杂性,因为它们迫使所有中间方法都意识到它们的存在,即便这些方法并不需要使用这些变量。此外,如果一个新的变量出现(例如,系统最初构建时未支持证书,但后来决定添加该支持),你可能需要修改大量接口和方法,以确保该变量能够通过所有相关路径传递。
- 我最常用的解决方案是引入一个上下文对象,如图7.2(d)所示。上下文存储了应用程序的所有全局状态(任何原本需要传递的变量或全局变量)。上下文远非理想的解决方案。
- 存储在上下文中的变量大多具有全局变量的缺点;例如,可能不明显为什么存在某个特定变量,或者它在何处被使用。如果没有纪律,上下文可能会变成一个巨大的数据杂烩,在整个系统中产生不明显的依赖关系。上下文还可能引发线程安全问题;避免问题的最佳方式是使上下文中的变量不可变。遗憾的是,我尚未找到比上下文更好的解决方案。
- 异常处理和配置参数
- 这些方法在短期内会让你的生活更轻松,但它们增加了复杂性,导致许多人必须处理一个问题,而不是仅仅一个人。例如,如果一个类抛出异常,该类的每个调用者都必须处理它。如果一个类导出配置参数,每个安装环境中的每个系统管理员都必须学习如何设置它们。
- 因此,应尽可能避免使用配置参数。在导出配置参数之前,自问:“用户(或更高级别的模块)能否确定比我们在此处确定的更优值?”当确实需要创建配置参数时,尝试提供合理的默认值,以便用户仅在特殊情况下才需提供值。理想情况下,每个模块应完整解决问题;配置参数导致解决方案不完整,从而增加了系统复杂性。
- 抛出异常容易,处理异常却难。因此,异常的复杂性主要来源于异常处理代码。减少异常处理带来的复杂性损害的最佳方法,是减少需要处理异常的地方。
- 异常屏蔽并非在所有情况下都有效,但在其适用的场合,它是一个强有力的工具。它能够产生更深层次的类,因为它减少了类的接口(用户需要了解的异常更少),并以屏蔽异常的代码形式增加了功能。异常屏蔽是向下转移复杂性的一个例子
- 最佳方法是重新定义语义以消除错误条件。对于无法消除的异常,应寻找机会在较低层次上屏蔽它们,从而限制其影响,或者将多个特殊情况处理程序聚合为一个更通用的处理程序。
- 设计两次
- 软件设计的哲学与美学
- 时刻重构
- 如果你想为一个系统保持一个干净的设计,在修改现有代码时必须采取战略性的方法。理想情况下,当你完成每一项改动后,系统应具备如果从一开始就考虑到这些改动而设计的结构。为了实现这一目标,你必须抵制快速修复的诱惑。相反,要思考当前的系统设计是否仍然是最佳的,考虑到所需的改动。如果不是,就重构系统,以便最终获得尽可能最佳的设计。通过这种方法,系统设计随着每一次修改而不断改进。
- 设计的重要性与价值
- 良好软件设计的一个重要元素是区分重要与不重要。应以重要的事物为核心构建软件系统。对于不太重要的事物,应尽量减少它们对系统其余部分的影响。重要的事物应加以强调并使其更加明显;不重要的事物则应尽可能隐藏。
- 一旦你确定了重要的事物,你应该在设计中强调它们。强调的一种方式是通过突出:重要的事物应该出现在更可能被看到的地方,比如界面文档、名称或频繁使用的方法的参数。另一种强调的方式是通过重复:关键的想法反复出现。第三种强调的方式是通过中心性。最重要的事物应该位于系统的核心,它们决定了周围事物的结构。一个例子是操作系统中设备驱动的接口;这是一个核心想法,因为成百上千的驱动程序将依赖于它。
- 专注于最重要的事物的理念不仅适用于软件设计,在技术写作领域也同样重要:使文档易于阅读的最佳方法是在开头识别几个关键概念,并围绕它们构建文档的其余部分。
- 软件开发中的“好品味”
- “好品味”这一短语描述了区分重要与不重要事物的能力。拥有好品味是成为优秀软件设计师的重要组成部分。
- 成为优秀设计师的回报是,你能够将更多时间投入到充满乐趣的设计阶段。而糟糕的设计师则大部分时间都在复杂且脆弱的代码中追踪错误。如果你提升自己的设计技能,你不仅能更快地产出更高质量的软件,而且软件开发过程本身也会变得更加愉快。
- 时刻重构
17 - 多语言的 Hugo 博客
之前看到了某位同学的分享,提到他在将博客多语言化之后,访问量有了显著的上升,于是也想试试看。在 OpenAI 的加持下文章翻译并不是什么难事,但是想要给一个现存的 Hugo 站点增加多语言支持依然不轻松。虽然 Hugo 本身自带了多语言支持的基本特性(文档:Hugo Multilingual),但是倘若选用的主题不支持,则还需要对主题进行改造。
目前对本博客,我选择了"按文件名翻译"的做法,从文档来看这似乎是对现有文件结构侵入最小的方案。简单来说,如果你的博客 Markdown 文件位于 /content/blog.md,在同层级下新建一个 blog.en.md 即可补充英文翻译。完成后可以通过在域名后补充 /en/ 路径的方式来访问。(主语言,在我这里是"简体中文"的路径不受影响,即无需补充语言后缀。)然而让用户手动补充语言路由显然是不可接受的,于是得在页面某处加一个语言选择器。这里我暂时加到了顶部。然后你的多语言博客就可以上线了。
目前已知还存在的一些问题,待之后有空再来慢慢解决吧:
- 各种导航(例如左上角的后退)会回到站点根目录(也就是简体中文主页);合理的做法是回到当前语言的对应主页
- RSS feed 链接有问题,默认提供的仍然是主语言的 RSS 链接,英文的链接在
/en/路径下;这里可能要考虑一个整合的 RSS?
大部分的核心多语言代码可以从这个 commit 看到:ca7a83d
更多参考链接:
18 - 我的 AI Prompt
记录下自己自用的一些 Prompt。只是迭代下来感觉还不错,但不一定是最好的。如有推荐欢迎回复补充。
通用场景
(主要配合 GPT-3.5-Turbo 使用,回答代码类问题)
摘要总结(英文)
(主要配合 claude-instant-v1 使用,用于文章摘要、结构化总结)
摘要总结(中文)
(主要配合 ChatGLM-Turbo 使用,用于文章摘要)
19 - 用 mitmproxy 让 ChatGLM 适配 OpenAI 接口
最近看到了几篇关于智谱 AI 的推送文章,才想起来他们的大模型(ChatGLM 系)已经上线好久了。回想 6B 模型刚公布的那会还在 AutoDL 上自己跑过,不过因为模型本身太小,所以其实能做的并不算多。注册了个开发者账户看了看文档,目前可以广泛使用的是 ChatGLM-Turbo,上下文窗口 32k token,定价 0.005 元/千token,还是很便宜的。更不用说因为 GLM 系模型以中文语料为主,所以同等长度的中文文本,用 GLM 的 token 消耗比用 GPT 系列的 token 消耗会小很多(测试下来大概在 4x 左右)。
官网的 Playground 玩了一会感觉还不错,生成的中文明显感觉更自然,没有 GPT 系那么浓烈的翻译腔,于是想着怎么接入到我自己用的客户端 Chatbox 中日常使用。Chatbox 有内置的 ChatGLM 支持,一般直接设置下 token 就可以了。但是因为我主要用的还是 GPT 系模型,而 Chatbox 又只能全局设置一个 API 服务器字段,所以如果要同时使用 GPT 和 ChatGLM 的话,还是得用之前提到的 mitmproxy,手动完成请求的中转(没有什么是加一个抽象层不能解决的)。这里用 mitm 方式让 GLM 适配 GPT 接口还有个额外的好处,那就是只支持 OpenAI 的第三方应用也可以自动支持 GLM 了(虽然我还没这么用过)。
和之前适配 OpenRouter 不一样,这次除了修改请求头,还要修改 SSE 响应体。不知道出于什么考虑,GLM 系列模型的响应事件和 GPT 系列的完全不同,修改起来还是有些复杂的。但总之调试了几个小时之后总算是改完了,代码在此:(不建议在生产环境使用,后果自负)
https://gist.github.com/jerrylususu/3ebcf6262d110da89ce58d1e8d55bc22
改请求头比较简单,修改如下:
- 换 host 和 path
- 换 Authorization 头:参考 GLM 开发文档的"鉴权"一节即可(注意这里要用
PyJWT库,直接二进制安装的mitmproxy带的 Python 环境不支持安装包,需要走pipx安装,可参考官方文档) - 消息列表(
messages)修改:GLM 系里叫做prompt,而且根据实测只能支持user-assistant交替,如果存在system或是有两个连续的user消息都会报错;这里稍微转换了下,把所有的非user/assistant消息都转成user,然后手动连接下连续的同 role 消息,保证最后构造的消息列表是两个角色交替。 - 开启增量返回:默认似乎是全量返回,这里和 OpenAI 对齐,也改成增量
比较烦人的是改响应体,如下所示分别是 GLM 系的返回和 GPT 系的返回。可以发现 GLM 系列比较简单,只有事件类型、流 ID 和增量数据;GPT 系列就更复杂一些,返回的是个 JSON,里面还有嵌套结构。
这里的改造思路其实很明确,先解析 GLM 的响应体,再据此拼装成 GPT 的相应格式,然后返回给应用就可以了,然而具体做起来还是有不少坑。
- 一开始想的是直接 decode 之后分行解析,后来发现不太确定是信道问题还是服务器问题,有的时候接收到的 SSE 事件只有一半(导致 utf-8 decode 失败),或者是两个事件被合并成了一个事件(一个 SSE data 里面有两个 add 事件)。用国内的术语来说这个算粘包?为了解决这个问题,先把行解析改成了正则解析,然后用补充了一个 buffer,如果发现这次的事件不完整就先扔 buffer 里,等下一个事件凑齐了再一起解析。
- 改完发现可以正常显示回复了,但是一直不能结束。还需要参考 OpenAI 的响应,额外补充
DONE事件。 - 这样改完倒是基本能用了,但接下来发现还是不太对劲,生成代码的时候会多一个空格。这里看了响应数据,返回响应的确如此,于是在 data 开头两个空格的时候手动删掉一个。
- 然后发现生成 markdown 列表的时候换行消失了。查响应发现有时会有多个
data:,需要每个都处理。
目前的效果算是初步可用了吧,但是偶尔如果响应本身不完整(例如某个 SSE 事件返回了不完整的 utf8 编码字符串,下一个事件没有包含丢失的数据),那就会直接报错。不过考虑到实际频率比较低,重试的成本比较小,这里还算可以接受吧。
20 - 用 mitmproxy 重定向 OpenAI 请求到 OpenRouter
背景
最近在尝试使用一些基于 GPT 开发的工具,但遇到了一些网络相关的小问题。因为支付方式的限制,我自己并没有 OpenAI 的账户,实际使用的 API 是其他中间商(aka 二道贩子)转卖而来的, OpenRouter 就是其中一家。(实际上 OpenRouter 做的还更多一些,更像是 LLM 的聚合提供商,除了 OpenAI 也有其他家的 LLM,如 Claude 或是 LLama。)但是很多开源工具并未考虑到这种情况,基本上都是假定用户使用的就是 OpenAI 的官方 API 端点,所以很多时候并不能直接使用各类预先构建好的产物(例如 docker 镜像),而是得把源码 clone 下来,找到 import openai 或者是类似的调用发起位置,再在附近补充一些参数才能正常使用。手动改代码固然不是不行,但是总归还是有些繁琐,出问题的时候还额外增加了一个需要排查的环节。
问题
有没有更好的,更自动化的方式,例如在网络上加个代理层,在第三方工具无需修改的前提下,就可以将 OpenAI 的请求转换成 OpenRouter 的请求呢?
解决
那既然都写到这里了,当然是有的。这里的核心是一个 man-in-the-middle (mitm / 中间人)代理,在请求到达代理的时候,修改请求中的内容,使之符合我们的要求,之后再继续对外发送就可以了。mitmproxy 就是这样一个工具。当然它的功能远不止修改请求,在完善的 Python API 的加成下还能做很多其他的事。(同类的工具其他工具,如 Fiddler,应该也能实现,但方法就需要给位自行探索了。)以下就是实现本次需求的核心代码,应该不需要太多解释。
启动 mitmproxy 时需要带上 Python 脚本参数,以及如果有上游代理则需要再声明:
启动后会弹出 mitmproxy 的网页控制台,这时候就用第三方工具发请求试试了,一切顺利的话可以看到结果正常返回且网页上显示请求数据。如果出现问题也可以看命令行窗口的输出。如果第三方工具本身支持设置应用内代理(如 Chatbox)则最理想;不支持的话可以考虑设置系统代理、用 mitmproxy 的透明代理模式、或者用 Proxifer 这类工具来强制应用代理。
21 - 健身房等待时间模拟
七月中旬去了趟医院,在医生的建议下开始定期运动了。综合考虑工作日的时间安排和自己的身体状态后,暂且决定每天中午去健身房运动一会。目前每日运动就是中午去健身房踩20多分钟的椭圆机(顺带看一集番),消耗热量约320卡。然而虽然健身房里的椭圆机数量并不少,足足有10台,但是偶尔还是会发生去了没有位置,需要等人结束的情况,但是因为不知道到底要等多久,还是略微有些焦虑。于是在想,有没有办法量化等待时间,例如模拟计算下概率分布函数,所以有了这篇文章。
代码(基本是 GPT3.5 写的,有手动调整):https://gist.github.com/jerrylususu/2d8f7099a1c4af37160179b12ce13895
假设:有 10 个椭圆机,每个椭圆机上的运动者的运动时间 t_n 遵循均值为 μ,标准差为 σ 的正态分布。到达健身房时,所有 10 台椭圆机都已被占用,且每个运动者的剩余时间在 [0, t_n] 中均匀分布。等待时间为所有运动者剩余时间的最小值。
考虑到参数 μ 和 σ 都无法被准确估计,因此考虑 μ = 5/10/15,σ = 20/25/30,组合起来共 9 种情况;对每种情况运行一万次模拟,统计等待时间的 p50/p75/p90/p95,得到下表:
| μ | σ | mean | p50 | p75 | p90 | p95 |
|---|---|---|---|---|---|---|
| 20 | 5 | 1.698 | 1.252 | 2.406 | 3.817 | 4.811 |
| 20 | 10 | 1.258 | 0.858 | 1.772 | 2.944 | 3.813 |
| 20 | 15 | 1.151 | 0.737 | 1.604 | 2.761 | 3.641 |
| 25 | 5 | 2.198 | 1.632 | 3.123 | 4.978 | 6.229 |
| 25 | 10 | 1.769 | 1.258 | 2.494 | 4.077 | 5.213 |
| 25 | 15 | 1.477 | 0.967 | 2.069 | 3.508 | 4.634 |
| 30 | 5 | 2.671 | 1.977 | 3.813 | 6.059 | 7.515 |
| 30 | 10 | 2.284 | 1.669 | 3.219 | 5.186 | 6.632 |
| 30 | 15 | 1.965 | 1.364 | 2.720 | 4.624 | 6.019 |
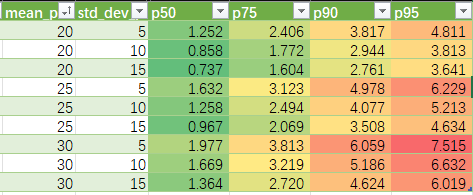
结论:考虑所有情况,一般等 2 分钟就有 50% 概率可以等到位置,最坏情况下等 6 分钟也有 90% 的概率等到位置。
22 - 评论系统从 Disqus 迁移到 Giscus
之前一直用的是 disqus,但是一来国内访问有时会有问题,二来新用户需要重新注册。考虑到大部分阅读本站的读者应该也是 Github 用户,迁移到 Giscus(一个基于 Github Dicsussion)的评论系统看起来更合适一些。切换评论系统本身并不难,参考这篇教程修改 hugo 的模板和配置即可。迁移数据也不算麻烦,毕竟没什么人评论,所以其实只有两条评论,手动迁移也就花不了多少时间(虽然也尝试了自动的方案但似乎有些问题,迁移过去的评论不显示…)。稍微有些烦人的反倒是 Giscus 明亮/暗黑模式的切换问题。
因为本博客有自己的切换按钮(见前文),用户访问的时候可能从 localstorage 中取颜色模式偏好,但是目前加载 giscus 是 hugo 在站点生成的时候就将颜色偏好参数写入 html 源码了,因此需要在用户点击按钮切换时,一并切换 giscus 的颜色偏好。参考官方的这个 issue 这一功能并不难实现。然而这样依然有问题,因为 giscus 加载后,用户点击按钮切换颜色模式偏好前,giscus 的颜色偏好是基于我的 hugo 配置文件,而非用户 localstorage 里存储的,结果就是可能用户手动选择了明亮模式,但浏览器设置里有 prefer-color-scheme: dark,所以 giscus 显示黑色背景+白色文字。之前的 issue 里对这个问题没有太好的解法,看到有人 setTimeout 不断循环,但感觉这不太优雅。读了一下官方文档,发现其实 giscus 会在加载完成后向父窗口发送事件,所以其实只要监听这个事件,在 giscus 加载完后再设置 giscus 的颜色偏好即可。相关实现可参考这个 commit。
可能切换了之后会有更多评论?但愿吧。
23 - 随机分享(230910):Typescript 中 Any 关闭类型检查 & Linux 中的内存占用
(没有干货,全是湿货…不过至少写一些总比完全没有写强?)
本周遇到的 Bug
遇到了两个前端相关的 bug,排查了很久,不过最后发现都是人的问题而非代码的问题…
- CI 坏了还能跑?
- 现象:某前端项目,其他人参加开发的时候发现 master 分支无法
npm install,但之前这个 repo 一直在正常更新版本,看 CI 日志也一切正常 - 原因:发现问题是上游某依赖方对已发布的包重新发布,导致文件 hash 变化,
npm install时实际文件 hash 和 lock 中 hash 不一致,所以失败;CI 之所以能跑是因为流水线里加了一层 cache,只要packages-lock.json不变就会复用之前的 cache,而恰巧上游重发包之后这个文件一直没变过,所以每次跑 CI 都是拉的已有的 cache,没有实际在流水线里执行npm install,未能即使暴露故障 - 解决:重建
packages-lock.json,让 CI 中的 cache 无效
- 现象:某前端项目,其他人参加开发的时候发现 master 分支无法
- 本地坏了,线上是好的?
- 现象:某前端项目,例行更新依赖库版本,发布前自测发现某功能测试环境不可用;但相同功能在线上一切正常
- 原因:拉线上版本回本地排查,发现线上的版本和实际代码的主干版本不一致(!);查阅发布记录,发现线上版本最近发布已经是一年多之前。和开发了解,原来现在的这个前端项目是原来的两个前端项目合并而来的,部署的时候其实要部署两次,但合并后的部署只部署了另一个模块,而没有部署当前模块,所以现在线上跑的实际上还是合并前的版本。
- 解决:修复代码问题,本地验证通过后发布线上;补充 readme 说明发布时需要两个模块都发布
Typescript 中 Any 关闭了类型检查
某后端项目,因为历史原因代码中有较多 any。最近发现代码中某处接受用户输入的位置有问题,默认值的类型不正确但依然通过了编译。示例如下:
注意到这里 nullish coalescing (??)的默认值是个 string 而非 string[]。这段代码感觉上上不应该通过编译,但是因为 (req.body as any) 的 any 类型禁用了类型检查,因此编译时不会再检查缺省值,实际上可以编译通过。而如果不巧后续有函数需要使用 string[] 才有的方法,而 req.body 中的 names 的确为 undefined,就会导致问题。
要解决这个问题,需要提供了更强的类型提示,让 Typescript 的检查可以正常执行。
Linux 中的内存占用
Linux 进程内存不同计算方法的区分:VSS, RSS, PSS, USS
可以把进程的内存占用视作上图。首先程序有自己独占的虚拟内存空间(Exclusive),其中可以分为已经使用了的(B)和属于自己但还未使用的(A)。其次进程还会使用一些共享内存(Shared),例如 so 动态运行库和 mmap 映射。考虑到这些共享内存多个进程都会用到,将其完全计算在某个特定进程名下听起来就不太合理,因此这里可以考虑类似于现实中的"公摊面积",根据实际使用的进程数把这部分内存占用平摊成 N 份,当前进程只计算其中一份(C),剩余的计算在其他进程下(D)。
由此我们可以得到四种不同的计算方法,见下表
| 指标 | 含义 | 组成 | 说明 | 图例 |
|---|---|---|---|---|
| VSS | 虚拟内存集合(Virtual Set Size) | 所有进程地址空间中的所有内存 | 进程可以访问的虚拟内存空间大小 | A+B+C+D |
| RSS | 常驻内存集合(Resident Set Size) | 进程当前实际使用的物理内存 | 实际分配的内存,不需要缺页中断就可以使用 | B+C+D |
| PSS | 共享内存集合(Proportional Set Size) | 进程当前实际使用的物理内存,按比例分配共享内存 | 按比例分配共享内存,适用于多个进程共享同一块内存的情况 | B+C |
| USS | 独立内存集合(Unique Set Size) | 进程独占使用的物理内存 | 只包含进程独占使用的物理内存,不包括共享库和映射的文件 | B |
其他
最后顺带一提,本博客目前把 RSS 改为了全文输出模式(参考这篇文章,实际 commit),希望可以帮到在 RSS 阅读器中阅读本博客的读者。
24 - 播放 Lofi Girl 的小脚本
自测 Lofi 对集中注意力有些帮助,然而如果长时间用 Chrome / Firefox 来播放似乎会导致奇怪的内存溢出问题,原因可能和 Youtube 的播放器默认会缓存已播放的片段有关。换用 MPV 似乎可以解决此问题。于是顺手写了个小脚本,结合 yt-dlp 和 mpv,一键播放 Lofi Girls。使用前请先自行下载 yt-dlp 和 mpv。
另外附上一些常见快捷键(完整见此)
25 - 在 devtool 控制台里爬网站
最近需要从某个不提供 API 接口的网站爬数据。F12 切换到网络标签页,然后重载页面,可以轻松的观察到其实其实后台是有提供给前端的 API 的。(形如 POST /api/entity/:id)。用 Edge 浏览器自带的 “编辑并重新发送” 功能测试,手动也可以调通。(这是 Edge 浏览器一个超棒的功能,对于偶尔的小调试可以替代 Postman)。理论上到了这一步就可以写点 Python 把数据遍历 ID 把数据爬下来了,不过可能还要处理一些 cookie 之类的麻烦事。与其再写个外部脚本,为什么不在浏览器的控制台里直接写脚本爬呢?
大概框架如下:
还需要一些辅助函数:
以上,祝使用愉快!
26 - 用 CSS Filter 反色实现简易黑暗模式
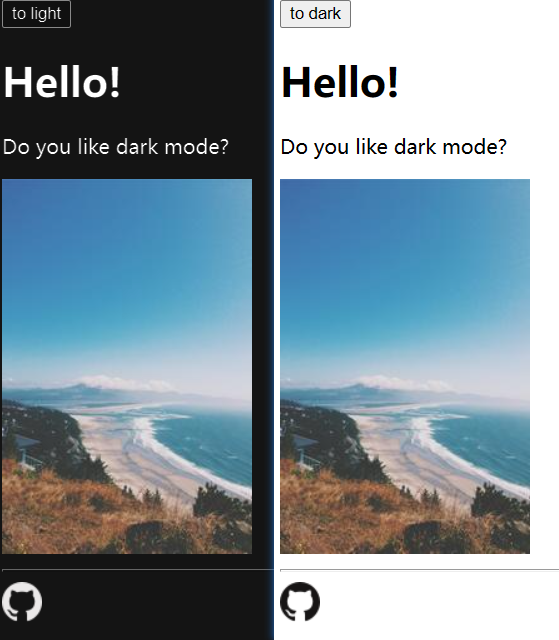
本博客使用的 Manis 主题 并没有提供原生的黑暗模式支持,于是考虑着自己加一个。一开始的想法是定制 CSS 加上 media query,然而这样改动面似乎会比较大。随手搜索了一下,发现已经有前人提出了使用 CSS Filter 实现简易黑暗模式的想法,甚至有代码可以直接应用于 Hugo 博客。相较于 media query,直接使用 CSS Filter 不仅操作上更简单,也允许用户直接切换明亮/黑暗模式,而不需要调整系统/浏览器的全局设定。
具体 CSS 实现中,先使用 invert(1) 对整个网页的颜色反相,但这一操作也会引起颜色的色调反转,因此需要再用 hue-rotate(180deg) 将色调转回来。然而这样的操作对文字而言很合适,但是会影响图片、视频等元素的显示,如同被 X 射线照射一般,最后还需要对这些需要被黑暗模式排除的元素再用一次 invert(1) hue-rotate(180deg) 负负得正转回来。
为了让用户能够切换明亮/黑暗模式,需要引入一个额外的切换图标,点击时会对应插入/删除黑暗模式的 CSS tag,并将用户的设定保存到 localstorage。在用户未明确设定偏好时,应遵循系统/浏览器全局的黑暗模式设定,因此这里又用 window.matchMedia 来探测。
完整修改可见于我给这一主题实现黑暗模式的 Pull Request,一个简单的示例可见于 Gist。最后的效果如下。
12/27 更新:PR 已被接收并合并。
27 - VNC 连接到物理屏幕
如果搜索 Linux 远程桌面,大部分教程基本上都是 xrdp + xfce4 的组合。一般情况下这样的组合的确不错,不过有一些诡异的特殊需求的时候就没那么好用了。在我的使用场景中,有的时候在实验室的 Linux 工作站上开启了一个比较长时间的任务,回到宿舍后可能需要检查下运行过程是否正常。如果是一般的 CLI 程序,用 screen 或者 tmux 之类的 terminal multiplexer (终端多路复用器)就绰绰有余了,可惜我用的是一个 GUI 程序。因此试着搜索了一番,发现是可以实现 VNC 连接到一个进行中的 X session 的,效果和 teamviewer 之类的工具差不多,具体操作如下。
- 安装 TigerVNC 服务端
- 运行
vncpasswd创建 VNC 密码 - 启动 TigerVNC 服务
- 使用
x0vncserver开启一个连接到 Display 0 的 VNC 会话 - 在其他设备上使用 VNC 客户端连接
在 Windows 上,根据我自己的体验,似乎 RealVNC Viewer 的使用体验比 TigerVNC Viewer 更好。
另一个可能会影响使用体验的问题是缩放与屏幕分辨率。实验室的工作站是 4K 屏幕,使用 200% 缩放,在用 1080p 的笔记本连接的时候不免感觉字太小。TigerVNC 似乎有一个 auto-scaling 功能,然而因为我们是把 VNC 会话连接到物理屏幕上,这一功能似乎无法使用。我自己的解决方式是先连上去,再手动改远端系统内的分辨率设置(一般改到 2560x1440 就足够了),然后重启 x0vncserver 再重新连接。虽然稍微有些麻烦,但是至少解决能用的问题了。
28 - 构造能匹配所有 emoji 的正则表达式
在研究一个 CSS 定制 Emoji 字体问题的时候,看到了一个 RegEx,可以匹配所有的 Emoji(至 2018 年版本),也给出了相应的测试例子,见此:Regex to match all emoji - Regex Tester/Debugger
看完之后我半信半疑,因为这个 RegEx 太简单了,于是手动转换成了对应的 Unicode codepoint 范围检查了一下,结果发现的确有问题:这个 RegEx 的匹配范围太大了,忽略 Copyright 和 Registered 符号(u+00a9, u+00ae),剩下的区间分别是 [u+2000, u+3300] 和 [u+1f000, u+1fbff]。后者还算合理,查 Wikipedia 上 Unicode 平面映射,基本上也就是新增 Emoji 的对应 codepoint;然而前一个区间就太过广泛了,甚至连日文平假名、片假名都会被匹配上。(不过的确覆盖了几乎完全的 Emoji codepoint,虽然有些类似于 Selector 之类的边角没覆盖到)
那么怎么做一个能精确匹配 Emoji 的 RegEx 呢?思路很简单,首先从 Unicode 官网获取 Full Emoji List,解析其中所有属于 Emoji 的 codepoint,排序,最后把相邻的 codepoint 合并成一个 range。然而说起来容易做起来难,RegEx 的视角中,字符是 UTF-16 的(如果要用 \uabcd 的形式的话),因此需要把高于 u+ffff 的 codepoint 用代理对的方式表示。
最后结果如下:(测试地址:regex101 )
最后的灵魂问题:你真的应该用正则处理 Emoji 吗?
后记:自己造完了轮子之后,才发现已经有人做过这样的工作了,emoji-test-regex-pattern。而且相比我的单字符匹配方式,这个 repo 里的 Regex 可以匹配代表 Emoji 的字符序列(如中国国旗=国旗+中国),更加符合 spec。
29 - Go 监控协程数量
继续补全之前写 Raft 的 debug 过程。在解决了 Timer 问题之后,发现如果多次重复测试(用 --count 10),依然会存在 CPU 占用率不断上升的情况,虽然上升幅度有所减小,但多次循环之后依然很严重。初步怀疑是角色转换的时候,可能协程没处理好导致出现了 goroutine 泄露,于是找了找 Stack Overflow,魔改了一个能间隔一定时间打印出当前 Go Runtime 中协程数量的代码。最后发现的确是随着测试进行,协程数不断上升;修复泄露问题后(加了各种判断 flag),每次测试重新开始的时候,协程数会降低到和一开始差不多的水平,多次测试的资源占用也正常多了。
30 - Go Timer 的使用姿势
之前写 Raft 的时候,用 Timer 来处理定时事件,但是之后在测试的时候遇到了一些诡异的问题,具体表现是随着测试重复进行,CPU 占用率越来越高。上 pprof 检查了一下,发现存在 Timer 泄露,根源是自己 Timer 的使用有些问题。下文记录正确的 Go 中 Timer 的使用姿势。
使用场景:
- 如果有 channel 里有数据(发生了事件),从 channel 里取出,并重置 heartbeat
- 如果没有事件,维持 heartbeat
例子:
- heartbeat interval = 1s
- event @ 200ms, 600ms
- 预期输出:200ms event, 600ms event, 1600ms heartbeat, 2600ms heartbeat ..
错误用法:
- 错误用法1:在 for 里,select 外用 time.Tick,每次循环都会产生一个新 Ticker 且不会被 GC (CPU 不断上升)
- 错误用法2:在 for 外用 time.NewTicker 创建一个 Ticker,但是不 Close (consumer 退出后 Ticker 依然存在,可以用 pprof 发现)
正确用法:for 外用 time.NewTicker 创建一个 Ticker,defer close,然后在 select 内,如果有事件则 reset。
示例代码:
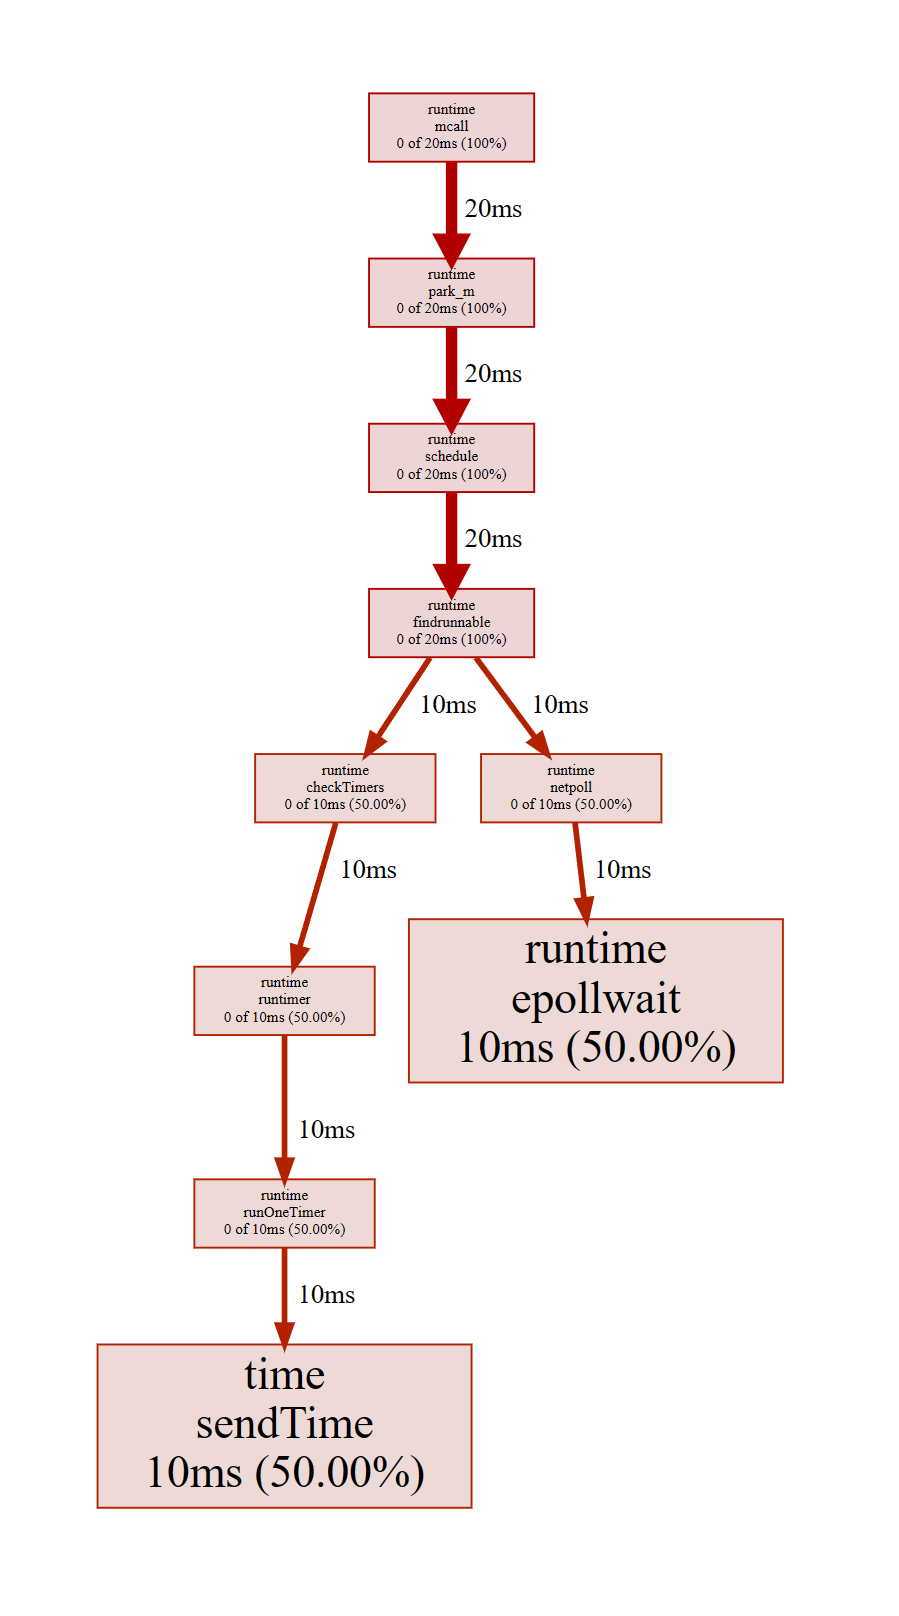
如果使用上文代码中标记 faulty 的版本,在 pprof 的输出中可以发现 epollwait 和 sendTime 占用了大量的 CPU 时间。在 Raft 作业的测试中,每个测试样例都会开启一个新的 Raft Run,但是不会重启 Runtime,导致之前样例中泄露的 Timer 在整个测试过程中会一直存活,CPU 占用率不断上升。
31 - MS RDP 无法连接到在使用了 802.1x 认证的无线网络中的电脑
昨天遇到了一个诡异的 bug,笔记本电脑放在 lab,连上了学校的 WiFi,但是回宿舍后却无法用 RDP 连接上。具体表现是一开始可以 ping 通,使用 RDP 连接时卡几分钟,随后超时断开,最后远端(笔记本电脑)就再也 ping 不通了。
以「RDP wifi disconnect」为关键词进行搜索,找到了微软知识库里的一篇文章:Remote laptop disconnects from wireless network | Microsoft Docs,描述的症状和我体验的很相似。文章大意是说 RDP 在遇上 802.1x 认证的时候会有一些 bug,需要调整网络认证方式为「用户或计算机认证」或「计算机认证」。
找到了解决方案就很简单了,不过文中提到的设置界面并不是很好找,以下为正确的设置方式:
打开「设置」应用,选择「网络和 Internet / WLAN」,在右侧相关设置选择「网络和共享中心」
在「查看活动网络」下找到自己连接到的 WiFi,点击蓝色文字

点击「无线属性」,选择「安全」选项卡,点击「高级设置」
在「指定身份验证模式」中,选择「用户或计算机身份认证」
至此无线连接会中断。点击任务栏的 WiFi 图标,重新输入用户名密码连接到网络。
设置完成后,建议使用手头的设备(平板 / 手机)尝试在同一网络下用 RDP 连接,如果能正常连接应该就没问题了。
32 - Markdown 表格内的代码块
Markdown 自带表格支持,不过表格内只支持基本的文本格式(加粗、斜体、inline code 等),而不支持更复杂的文本格式(如代码块、水平线)。如果需要在表格中加上复杂格式支持,如果使用的是 Github Flavored Markdown,一种做法是用 HTML 定义表格框架,再在内部 inline Markdown 文本,示例如下。
需要注意之处:
- 对应的 table cell 的
<td>,</td>标签需要在新行的行首(前面不能有缩进) - table cell 内的 Markdown 文本上下和
<td>,</td>标签之间需要间隔一个空行
效果:
| Column 1 | Column 2 |
| Code Block | |
| Horizontal Line | Markdown Some Text |
代码:注意代码块结束应该是 3 个 tilt(这里写两个是因为三个会导致渲染出错,提早结束代码块)
参考链接:
33 - Python __hash__ 继承
最近写作业的时候踩上了一个 Python 的坑:
如果父类实现了 __hash__ 方法,而子类重写了 __eq__ 方法,为了保证 hash 和 eq 的语义一致,子类不会隐式继承父类的 __hash__ 方法。如果需要子类的 __hash__ 方法调用父类的实现,则需要手动声明。
这个之所以是一个坑,因为在代码中的行为看起来很正常:
- Pycharm 的方法跳转可以定位到父类
__hash__方法 - inspect.getmro 的父类列表正常
- dir(object) 得到的方法列表中的确含有
__hash__
文档原文:
A class that overrides
__eq__()and does not define__hash__()will have its__hash__()implicitly set to None.
If a class that overrides
__eq__()needs to retain the implementation of__hash__()from a parent class, the interpreter must be told this explicitly by setting__hash__ = <ParentClass>.__hash__.
具体的实现(基于 CPython)
inherit_slots函数负责继承 slots Line 5432inherit_slots在处理比较相关的函数(comparison-related)的时候(Line 5432),会使用overrides_hash方法检查子类是否有重写__eq__,__hash__(Line 5274)overrides_hash中使用_PyDict_ContainsId方法先检查__eq__,再检查__hash__,如果任一存在则返回 1,否则返回 0- 如果
overrides_hash返回 1,则认为不能继承父类的__hash__方法,type->tp_hash不会被设定
以下为一个示例:
| Original | Modified |
|---|---|
相关链接:
34 - mdBook 代码折行(wrap)
mdBook 是一个基于 Rust 的文档网站生成工具。虽然 mdBook 中有代码高亮,可编辑代码等特性,但是默认情况下不支持代码折行的设定。在代码行或注释较长的时候,用户需要手动左右移动,体验不佳。
查阅文档可知,mdBook 使用的是 Ace Editor。再查询 Ace Editor 的文档,可以发现通过 editor.getSession().setUseWrapMode(true); 启用折行。
在 mdBook 生成的 book 文件夹中,可以找到 book.js 文件,在 line 6 开始进行如下修改,手动设定 editor 属性即可。
35 - Hugo 的 Disqus 整合
Hugo 是内置了 Disqus 支持的,理论上只需要在站点的 config.toml 的顶层设定 disqusShortname 属性即可,不过实际用起来稍微有些坑。具体步骤如下。
- 在 Disqus 官网注册自己的账户
- 在 Disqus 官网登陆后,选择右上角 Settings - 左侧 Moderation,然后在这里新建一个站点,站点名字 (
{site_name}.disqus.com)就是disqusShortname应该用的值 - 站点创建完成后,Billing 页选择 Free Plan
- 在 Hugo 的
config.toml文件中设定disqusShortname
其他小问题:
- 本地没有评论显示:主题的
disqus.html中(位于{site_folder}\themes\{theme_name}\layouts\partials\disqus.html),在本地执行(indow.location.hostname == "localhost")的时候不会加载评论框。如果调试需要,可以给这个判断加上注释,即可在本地正常显示了。
36 - JavaFX 打包并设定 UTF-8
IDEA 可以自动为 JavaFX 打包,会带上依赖 jar 和 Java Runtime,具体方法见视频。
然而这样打包生成的文件,在没有加 VM 参数时默认使用系统编码,在中文 Windows 环境下即使用 GBK,代码中若含有中文会造成乱码。
解决此问题的方法也很简单,只需要在打包后找到 {artifact_name}/app/{artifact_name}.cfg 文件,找到 [JVMOptions] 一行,在其后追加 -Dfile.encoding=utf-8 即可。然而需要每次打包后手动修改,并非最佳方法。
37 - 用 Slides 标题栏颜色区分重要性
Slides 标题栏除了展示标题之外,也可以用于表明本页的重要性。
例子:
- 「红色/橙色」代表本页十分重要,就算忘记了其他内容也应该记得本页。
- 「蓝色/幻灯片主题色」代表本页一般重要,即一般的正文层级
- 「绿色」代表本页内容为延伸、扩展或详细说明
- 「灰色」代表本页内容为参考文献、资料总览
38 - WSL2, Docker, Virtualbox
2021/4/9 更新: VMWare Player 16+ 无须配置,在检测到 Hyper-V 启动后自动调用 Hyper-V 后端了。
Docker 在 Windows 上运行,实际上都是靠一个 Linux 虚拟机。早期 Docker 官方出了一个叫做 Docker Toolbox 的工具,其实就是 VirtualBox 加上一个精简过的只能运行 Docker 的 VM。后来 Docker 放弃了 Virtualbox 路线,转而使用 Windows 内置的 Hyper-V 作为底层 VM。但是 Hyper-V 平台一旦启用,就会导致 Virtualbox / VMWare 等其他虚拟机工具不可用,这一问题直到 VirtualBox 6 之后才算解决,此时 VirtualBox / VMWare 都可以调用 Windows 内置的 Hypervisor API 作为 VM 的执行引擎。
所以来到 2020 年,在 Windows 10 20H2 上同时运行 WSL 2, Docker 和 VirtualBox 已经几乎是 painless 的了,只需要记住
- WSL 2 底层是一个跑在 Hyper-V 里的 VM
- 因为 WSL 2 是一个真正的 VM,Docker 可以直接安装到 WSL 2 中,而不会遇到 WSL 1 的不兼容问题
- VirtualBox 通过 Hypervisor API 调用 Hyper-V 来执行 VM
步骤也很简单:
- Windows 开启相关功能:Hyper-V, 虚拟机监视器,虚拟机平台
- WSL 迁移到 version 2 (如果喜欢也可以留一个 WSL 1,毕竟比 VM 轻量,日常也基本够用)
- Docker Desktop 安装最新稳定版
- VirtualBox 安装最新版(大版本号 6 及以上)
注意:
- VirtualBox 因为换了虚拟化后端,已有的暂停的虚拟机,启动的时候会丢失数据,建议关机之后再迁移
- VirtualBox 的 VM 性能可能会下降,64-bit Guest 尤其严重,32-bit Guest 还好(如果用 Hyper-V 作为后端,可以看到 VM 执行界面右下角是一个乌龟图标)