这是本节的多页打印视图。 .
长文
- 1: 软文检测器
- 2: 和颞下颌关节紊乱共存的十年
- 3: The drive to develop
- 4: 2024 年末杂谈
- 5: LLM x 书签收藏:摘要 & 全文索引
- 6: 工作两年了
- 7: 软考高级架构师备考记录
- 8: 2024 年了,我最近在用什么工具
- 9: End of 2023
- 10: 再次复活(2023)& 换用 Github Action 部署
- 11: 将已有的 Vue App 变为 PWA
- 12: Python `itertools.permutations` 使用的排列算法
- 13: (译) 复杂系统如何失效
- 14: 分布式系统课程笔记
- 15: 调用栈也是栈
- 16: Tensorflow 开发者认证记录
- 17: 再次复活
- 18: 不丢失数据的重装 - Repair Install
- 19: 给 WSL 安装桌面环境
- 20: Utils.ahk
- 21: 博客迁移记录
- 22: 我最近在用什么软件?
- 23: 耶[ ]复活啦!
(可能)更长一些的文章。
1 - 软文检测器
读某些新闻网站或公众号的时候,常常会越读越有种隐约的广告感(“这是广告吗?"),直到读到文末才彻底验证(”这果然就是广告吧!“)。之前买了 GLM 20 元一个月的 coding 套餐(agent 用的是 claude code),那就顺手 vibe coding 一个小工具来识别吧。于是就有了”软文检测器“。
这个小 app 本身并没有什么特别值得说道的,毕竟只是顺手做的玩具,代码我也没有仔细审查,看起来似乎没啥问题而且也能跑就提交了。作为一个 llm wraper,基本上就是一个 fastapi 后端加一个很简单的 vanilla js 前端(甚至没有用框架),前端提交内容后扔给 llm,然后用 sse 推送响应,来避免前端长时间卡住不出结果。模型上用的是 gemini-flash-2.0,是我能找到的速度-质量-价格最佳平衡点,而且 gemini flash 本身就极其便宜了,极大缓解了我的 llm 用量焦虑。prompt 是 deepseek r1 写的,在 repo 的 json 文件里可以找到,生成后稍微人工调整了一下但没有大改。
有人可能会好奇,在 llm 生成响应的过程中,返回的 json 并不完整,前端是如何保证展示有效内容的呢。实际上这里参考了苹果 wwdc 25 的 Snapshot streaming 的做法,虽然 llm 返回的响应并不是完整的 json,但是有库可以尝试从不完整的 json 解析出有效的 json,我用的是 promplate/partial-json-parser(原理大概是自定义一个更宽松的parser) ,在后端包一层,就可以确保前端每次 sse 拿到的 event 都是有效 json了(虽然可能部分字段不完整)。
自己稍微玩了玩,确认没啥问题了之后,就开始想怎么部署到公网上。vibe coding 极大简化了写代码(如果你不在乎这个项目的长期可维护性,只是想创建个能用的 mvp);但是 vibe deploying 并没有成熟度能与之相当的工具链。不少人用 supabase,但是对我这样一个简单的 llm wrapper 来说未免有点太重了,部署在别人的平台上也有点感觉不太安心(担心哪天超过 free tier 被收钱,虽然概率极其之小)。自己部署的话,又有不少前期工作需要做,例如子域名、网关、https、daemon化等等。我之前大部分分享出去的小工具都是纯前端的,扔在 github pages 上就完事了,最多写个 yaml 配置下 ci,带后端的对外工具实际上这还是第一个。最后分享欲还是战胜了嫌麻烦的心态,决定后端扔在一个不怎么用的云服务器上(服务器本身的开销可以忽略不计),前端还是放 github pages。最后满打满算下来,这个项目写代码&自测的时间,可能还没有准备部署环境&实际部署的时间长。
关于 llm 的应用,其实还涉及到一个控制用量(aka 限额)的问题。虽然我倒是不太介意在这种小玩具上每个月花点小钱(一瓶无糖可乐的价格都够一个便宜 llm 模型用很久了),但是我不想失去控制我能花多少钱的能力。一开始想的是在后端自己写个限额,或者直接用现成的库,但感觉涉及到钱的话还是有些危险,于是搁置了。手写限额的话,还需要考虑状态存储,就又多引入了一层复杂性(例如 cloudflare worker kv 每天只有 1k 写额度,上 durable object 或者 d1 也太重了。)顺带吐槽下,国内好几家主流的 LLM 服务提供商,都没有 by api key 限制使用额度的能力,但是在国外(如 openrouter)或各类中转商,这是基础的不能再基础的能力了。最后找了个支持 api key 限额的中转服务商,才算放下心来,知道再怎么刷也不会把我的账户刷爆了。
最后是可观测性,出于一些小小的私心,还是希望看看有多少人用过。为此前端加了 google analytics,后端用 opentelemetry 上报 trace 到 uptrace (他们家免费额度很宽裕)。最后实际上因为没怎么做推广(只在两个论坛上发了简单介绍),当然也没啥人用,最后大概是一天10个请求的样子,我自己的请求可能就占了一半。
一些未来的可能优化点(如果我还有兴趣在这个项目上继续投入的话):
- 把单纯的是否软文改成一个连续的光谱,或者至少多增加几个层级
- 现在对软文敏感度太高了,正常内容可能也会被认为是软文,看看怎么改 prompt 优化下
- 调查为啥得加 await asyncio.sleep 才能让 sse 正常工作
- 深入分析,补充到文内的引用
- 对文章按照”推广程度“染色(说实话我不太确定技术上这怎么实现)
另外还有一些想法:
- 可能对高级用户 bring your own key 的做法会更好,还能省去我部署后端的开发&运营复杂度;可能可以考虑把这个项目转换成一个支持自己提供 llm 接入和使用现成后端的模式?
- 进一步地,是否存在这样的生态系统,提供了统一的 llm 接口(例如一个 js/ts sdk),用户只需要装一个插件,在插件内配置一次,各个网站就可以直接使用用户已配置的 llm 服务?(似乎 chrome 有个内置的小模型,但是很多事情小模型还是不太够用)
- 之前试过扣子空间,虽然搭建简单原型没问题,但是分享起来异常困难(例如有审核流程);如果存在更简单的分享&创作方式,可能这类小但是有意义的 llm wrapper 会更广泛?
- 与其分享一个又一个 llm wrapper ,不如分享结构化 prompt 和支持运行结构化 prompt 的工具?(例如另一个之前的小创作 llm-prompt-templater )
这篇文章有点混乱,想到哪里就写到哪里了,只是我个人的 brain dump。如果你能读到这里,那真是辛苦了。
2 - 和颞下颌关节紊乱共存的十年
初识
大概是高一的时候,某个平凡的课间,我打了个哈欠,然后惊恐的发现右侧的下巴卡住了,完全合不上嘴。从此开始了和颞下颌关节紊乱共存的十年。
前几次发生的时候,每次我都如临大敌,校医对此也束手无策,最后只能叫家长来(跨越半个城市)到附近的医院,找口腔科的医生帮我复位。一般这个过程都很痛苦,医生需要在口腔里使劲和关节搏斗。那会大概一个月会出现一次。比较好笑的是,某一次晚自习脱臼又发生了,家长开车来学校,我上车后迷迷糊糊睡着了,醒来的时候还没到医院,但是我突然发现似乎脱臼自己恢复了,于是就直接掉头又回了学校。
自救
但是总是叫家长去医院也不是个事,于是我开始主动寻找缓解方法。在知乎的一个回答上看到热敷的建议后,我尝试用水壶装满热水靠在关节上,用热量让关节放松(医院红外射灯大概也是这个原理)。这个方法有时有效,但效果并不稳定——就像这个病本身一样难以捉摸。
高二那年,我去图书馆在知网上查阅医学论文,试图找到一些思路。这一次有了新发现:口外复位法。这个方法如此重要且有效,以至于我需要在此原文摘录:
以手指在颧骨稍下方颊部的皮肤上确定喙状突顶部的所在位置,然后将拇指放在上面,向后向下按压就能使脱白复位。
这种口外复位方法的优点是:不需要将手指放入患者口内,在无条件洗手的情况下也能进行,不需要太大的按压力量,不需要助手的帮忙,在坐、站、卧任何体位的情况下都能进行复位。不仅医务工作者容易掌握这一方法,习惯性脱白者亲属也能掌握。
我把这段文字抄到了自己的本子上,并决定在下次脱臼的时候尝试。下次脱臼到来时,我惊喜地发现这是可行的(尽管很痛,会痛到流泪的程度)。至少我现在有了个有效的自救手段。
高三某个晚自习的课间,我打了个哈欠,然后脱臼又发生了。但这次伴随着一个新的突破:当时我刚趴桌睡醒,不知为何决定猛地一仰头,然后关节复位,脱臼消失了!我不太确定这是怎么实现的,可能是加速度让关节冲过了卡点,或者是仰头的操作扩大了移动范围?这个仰头复位的方法,在绝大多数情况下都有效,但是依然有限制:一是必须要在脱臼发生后立刻执行,超过五秒成功率就会大幅下降;二是有的时候不方便仰头(例如落枕了),那就做不到了。
和解
脱臼第一次发生之后,我去看过医生,后面也陆续去过几家不同医院。医生怀疑和我小时候咬合习惯不佳相关(例如只用一侧牙齿咀嚼),但是没有什么好的治疗方式。可以手术,但是风险远高于收益,因此最后还是建议保守治疗,平常自己多注意。家长买过限位头套,但戴着像恐怖分子的造型让我几天后就放弃了。
如今,对我而言脱臼已经变得如此频繁,每天可能发生十几次,医学上称之为"习惯性脱臼"。幸运的是,绝大部分情况下我都能通过仰头自行复位,所以对日常生活的影响比较小。唯一的困扰可能是旁人偶尔会对我突然仰头的动作投来奇怪的目光。那些仰头无法解决的严重情况,我会找个无人的角落,用之前学到的口外复位法自己处理。每次这类无法自动复位的脱臼发生,需要我手动干预时,我会留下记录;前几年的时候情况比较糟糕,大概一个月一次,近期已经有所好转(可能和我拔了智齿相关),大概是每100天会出现一次。
值得庆幸的是,在高考和其他人生重要时刻,这个病都没有给我带来麻烦。现在的我已经完全接受了与它共存的状态,甚至发展出了一套"充电"理论——定期按摩关节区域就像充电,如果等到"电量耗尽",关节就会卡住。
杂谈
如果你从未听说过这个病,那我衷心祝愿你永远不会有机会了解它。某种程度上说,在现代社会,对疾病知识知道得越少可能意味着越健康?但如果你或身边的人也受此困扰,希望我的经验能提供一些帮助。
3 - The drive to develop
这是一期杂谈,没什么干货。
“The drive to develop” 是早年间喷气式大脑(aka JetBrains)的一句宣传语。虽然目前无论是工作还是自己的项目里我用的都是 VSCode,但是毕竟大学编程的一大半时间都是在 JetBrains 家的各种 IDE 中度过的(毕竟有学生免费),所以对它家印象还是比较深的。第一次见到这句宣传语应该是在某次 ICPC 的直播上(当时 JetBrains 是官方赞助商之一),感觉直击心灵。在学校里的时候虽然有各种课程,但也有一些有趣的课程项目,再加上自己也会写点自己的东西,所以的确是有这种编程的动力的。这样的动力在工作后甚至也延伸了一段时间,上班的时候写公司的代码,下班之后忙自己的项目。
可惜这样的动力并没有延伸太久。随着工作年限增长,工作上要处理的事务也越来越多,虽然也写代码,但是写代码的时间并不是工作时间的大头,因为还有无数的关联任务需要完成(设计文档、代码评审、发布、告警处理…)。即使是到了周末,也会因为周中的工作几乎耗尽了精力,没有动力坐回电脑前写点什么;残存的精力已经只够我在床上躺着刷手机了,各种个人项目也因此停滞了很久。
但各类 AI 代码编辑器(更准确地说,是 LLM-assisted programming?)的出现改变了这一切。虽然 ChatGPT 早在 22 年底就发布了,但是我自己亲自上手体验已经是 23 年初。当时还是刀耕火种的时代,需要自己从网页里复制代码到 IDE 里。后来 Github Copliot 有了对话模式,可以稍微做一些交互式的任务了,但是因为没法自动 apply changes,最多只能 insert,体验还是不太行。再后来试用了 Cursor,第一次体会到了什么叫做 “AI-Native” 的编辑体验,变更大部分时间都可以直接 Apply 进去,不用再自己一个个找了;但是用起来还是感觉有点迟滞,例如因为索引还不太好使,很多时候都得手动指定某一个特定的文件加入上下文才能有比较好的效果。最近我在使用的是 Windsurf,起初不是很习惯(生成过程中看不到进度,和 Cursor 不同),但后来才发现了其 agent 能力的真正作用,多文件修改、代码库索引,再结合自带的联网搜索,真正做到了指哪打哪,信手拈来。
之前之所以空闲时间不太想写代码,并不是因为没有想法,而是虽然有想法,但是具体怎么实现的思路依然很模糊,而且中途还有高度的不确定性和时间成本,例如有的时候配环境就因为一些莫名其妙的依赖调试了两三个小时,或者是因为某一个感觉上很直接但是就是写不对的函数 rage quit。但是有了 LLM 之后,我可以直接对着编辑器说:去,把这个功能给我做出来,然后看着 agent 吭呲吭呲尝试各种方法,自己调试问题。虽然偶尔还是要人介入,但是心态上会好很多,感觉自己仿佛什么都能做。在我最近的一个小项目里,我给一个 Rust 的库实现了一个 web playground link 。虽然我知道步骤是先写一个 wrapper,然后编译 wasm,再写点 js 去调,但是里面有很多细节我是不知道的(需要装什么工具,怎么编译)或者是不想手动做的(例如写胶水前端代码)。于是我把我的思路告诉 LLM,一个小时之后我就有了一个能用的 demo。(其中甚至还包括至少二十分钟在等 rust toolchain 和 wasmpack 编译)这样的效率是之前自己想都不敢想的。
但是我也注意到,AI 代码编辑器的出现,只是帮助让有想法的人走的更快更远;如果一开始就没有想法,即使有这样的工具也不会去用。以我自己为例,AI 音乐/图片/视频生成已经实用化很长时间了,也有各类免费的服务可供选用,但是我却提不太起去用它们创作些什么的兴趣,也没有什么想法。由此推知,可能也有其他人心中有不少想让 AI 画出来的画面,有 the drive to draw,但是面对空白的编辑器窗口却不知道应该发出什么指令,帮助自己做什么事情吧。
最后,无论目标为何,希望大家都能找到自己趁手的工具,完成自己想做的事。
4 - 2024 年末杂谈
其实本来昨晚就想写了,但是因为工作安排需要线上值班,所以今天才动笔。2024 终于平安结束了,希望 2025 年也能一切顺利吧。
回顾 2024
- 工作
- 继续干着,职级正常升了一级;不过后续再往上升估计就比较慢了,得慢慢熬
- 做了一些更复杂的工作,还有几个大的跨部门项目
- 前半年被迫在一个不熟悉的领域干了很久,好在后半年回到了原来的业务
- 出了一个事故,好在影响不大;但是更提醒自己得谨慎再谨慎了
- 总体而言没有太大变化,不具体展开了
- 学习 & 阅读
- 年中考过了软考高级系统架构师;然而除了拿了一个实体证书,目前还没有起到什么作用
- 年底去考了 N2,不过实际上也没怎么学习,几乎是裸考了,应该是不可能过的
- 今年读了 7 本书,但是主要都是技术类的,非技术类的读的不多;印象深刻的是 《软件设计的哲学》(link),把一些工作上隐约能感受到但是想不明白的点给理清楚了
- 开源 & 写作 & 探索
- 更新了 12 篇博客,入选了 2 次阮老师的周刊
- 开源项目 mainonly 在 Github 上有 172 个 star,也成为了自己日常不可或缺的工具
- 书签增加了 326 条;新增了基于 LLM 的自动摘要 workflow ,未来找起来会方便一些
- 开了一个微信公众号,把部分内容同步了过去;甚至收到了一位读者的赞赏,虽然金额不大,但还是很开心
- Advent Of Code 2024:49/50,24p2 放弃了;发现自己对这类项目容易上头,很容易把下班后的时间全放在解题上了,还是心态不太行
- LLM 相关
- 尝试完全把 LLM 融入工作流,写了一些自用的小工具
- Cursor 开发起来还是很爽的,模板类代码都可以代劳了,有足够好的注释/变量名生成的自动补全也非常靠谱,但是遇到一些复杂的逻辑问题时还是会卡住(可能是我用的模型能力问题?)
- 不同的模型用多了会感觉有不同的性格,GPT 就比较简洁直接,Claude 虽然想得多但是有的时候会把方案做的太复杂;deepseek 就比较平衡,而且最重要的是便宜大碗,用起来不心疼
- 生活
- 今年出去旅游了 2 次:4 月清明假期去上海见了高中和大学同学,8 月去惠州海边试了下躺平生活;然而总体还是没有太多出门的动力
- 建立了工作日中午运动的习惯:一般就是在公司健身房,边踩椭圆机边补番,一次25min,约350kcal;运动完用 app 打下卡,还是挺有成就感的;看了下数据今年有 162 次运动记录,大概是工作日的 80%
- 从家里搬出来住:10 月底搬到了一个离公司比较近(一站地铁,可以步行)的位置,虽然新增了房租的开销,但是因为几乎没有通勤问题,生活质量极大提升,总体还是很值得的
- 更频繁的约饭:基本维持了一个月约一次饭的频率,不至于太频繁让人喘不过气,也不会太久以至于忘记之前聊了啥;对维持精神稳定很有帮助
- 更多文字记录:工作上用 Obsidien 写任务笔记,基本没有再遗漏过细节了,效率极大提升;尝到甜头之后开始在生活里也记录更多东西,无论是每次约饭聊了啥,还是每周有什么有趣/有意思的事情。如果不记录,很快就忘记发生过什么了
- 投资
- 今年开了股票账户;9月底的大涨没敢投入太多,因此也没赚多少,但好在最后没亏;实际体验过之后发现这种快进快出的风格还是不太适合自己,更习惯于一次买入就长久放着
- 总体年化收益率 2.3%,按收益率排行:公司股票 > A股 > 美元存款 > 人民币货币基金
- 被动收入(低风险无需操作的投资收益)基本达成了目标,一年的收益足够在房租低的城市完全躺平一年,但是安全边际还是太低了,还得努力提高投资水平
展望 2025
- 工作
- 希望能不出事故,继续干下去
- 探索其他的工作机会(私企 & 体制内),考虑后路
- 技术
- 用 LLM 学更多
- 用 LLM 构建更多
- 生活
- 继续保持运动习惯
- 每个季度读一本无关工作的书
- 学习日语到 N2 水平
- 投资
- 进一步分散投资
- 不亏钱
5 - LLM x 书签收藏:摘要 & 全文索引
背景
网上冲浪的时候,经常会遇到一些有趣的文章或者网站,让我有收藏起来以备后用的冲动(虽然绝大部分情况下都没有再用过)。然而一个人收藏未免有些太孤单了,因此自从 2021 年 5 月以来,我一直在使用一个名为 osmos::memo 的书签插件,将我的收藏直接记录到一个公开的 Github 存储库。这个插件的工作原理很简单,首先设置好 Github 的 token,然后每次点击收藏按钮都会在浏览器里临时 clone 一次,追加新收藏的条目到文件顶部,生成 commit 并提交,然后推送回 Github。但是这样简单的工作流程也十分有效,除了 token 过期的时候需要手动续期(过期前有 Github 自带的邮件提醒,所以基本上不会拖到最后),没有什么可以出错的空间,近三年半下来也已经帮我积累了 800+ 条目了。
问题
然而目前的书签收藏流程中,依然会存在一些问题。
- 书签指向的 URL 可能不再存在(例如某个博客的主人决定不再续费域名,或者是做了链接格式的调整),导致成为悬空的死链接
- 目前的记录项只有书签的 URL、标题和可选的标签(而且我打标签的习惯不太好,光靠标签基本上不太能找到),导致查找的时候如果对关键词记忆不清楚,很有可能找不到
- 书签里一大部分是长文章,时间一久很有可能忘记内容,如果只是临时找些东西,通读一次又略微有些费时费事,导致查找&引用效率下降。
解决
为了解决这些问题,我建立了一个新的存储库 bookmark-summary。这个存储库可以视为现有书签存储库的辅助数据,其中包含了新增书签的 Markdown 格式全文、列表摘要、一句话总结,和现有存储库之间通过 Github Actions 联动。其工作原理如下:
- 我通过书签插件,在现有的书签存储库中新增了一个条目
- 代码提交到主干,触发名为
summarize的 Github Actions(yml 工作流文件) - Github Actions 执行,首先 checkout 书签存储库和摘要存储库,然后执行 process_changes.py
- 首先解析书签 README.md 文件,找到最近新增的条目标题和 URL
- 将 URL 保存到 Wayback Machine
- 输入 URL,使用 jina reader API 获取网址的 Markdown 全文,并保存到
YYYYMM/{title}_raw.md - 输入 URL,使用 LLM 生成列表摘要(prompt 在
summarize_text函数 link) - 输入列表摘要,使用 LLM 生成一句话总结
- 将列表摘要和一句话总结保存到
YYYYMM/{title}.md(效果示例) - 更新摘要存储库的 README.md,增加到摘要文件的链接
- Github Actions 提交变更到摘要存储库
这里的主要代码基本都是 Claude 和 GPT4o 写的,人肉做了一些小调整。后面随着使用又逐步发现了一些 bug,最近还用 o1-mini 修复了一个,算是真切感受到了 LLM 对生产力的巨大提升。目前摘要生成用的是深度求索的 deepseek-chat,便宜是真便宜(输入 1元/1M token,输出 2元/1M token,在这个场景下的成本基本上是每个月1元不到),效果也还算可以。
未来
最后是一些已知问题,以及未来可能的优化方向。当然和其他所有项目一样,欢迎 fork & PR。
- 列表摘要质量:可能是 prompt 的问题,列表摘要倾向于每个大点下面只列两个小点,且没有充分合并需要合并的论点;可能需要考虑进一步优化 prompt,或者换用其他模型(不过我拿便宜的模型都试了一轮,基本上都存在类似问题)
- 数据结构化:目前摘要存储库下有个简单的 data.json,但是核心的摘要和全文内容依然是 Markdown 存储的,而不是 JSON 这类程序友好的结构化存储。可能需要考虑在 Markdown 之外另外维护一个 JSON,以备未来的查询。
- 代码整理和重构:目前所有逻辑都混在一个大的 Python 文件里,修改和测试起来都很烦人(实际上没有特别好的办法手动测试,目前都得靠手动注释掉部分代码)。未来一个考虑是做重构(o1-mini也给出过比较好的重构结构)+补充测试;另一个是改进书签存储库和摘要存储库的交互方式,例如通过读 git log 或者是明确传递最近书签条目的方式来触发摘要生成,而不是靠目前读文件对比的方式
- 向量搜索:目前虽然原文和摘要都存下来了,搜索却还是只能靠基本的文本匹配;可能可以考虑接个 embedding 模型自动生成下嵌入,存到一个 SQLite 数据库(或者用各种向量数据库 as a Service);主要是查询的时候也得生成 embedding,英文还有小模型可以搞,中文的模型都太大了,没法直接在前端跑不依赖后端服务,这里还得再仔细想想。
- 自动生成每周周报:
既然现在书签有时间信息,可以考虑每周新增的书签+原文+摘要全部往 LLM 扔,自动生成一个每周摘要,放在 Github Release 里(不过不知道有没有人愿意看就是了)(已完成,参见 Releases,实现见 build_weekly_release.py,代码主要由 o1-mini 实现) - 改用更现代的工具链:例如 uv,以及把依赖写在 Python 代码头部(PEP 723 Inline Script Metadata)?
我也想要
可以参考以下步骤,在自己的 Github 账户下部署一套类似的系统。(根据回忆写的,所以可能不太详尽)
- 参考 osmos::memo 的指引,初始化书签存储库(我的叫做 bookmark-collection),安装浏览器插件,并连接到 Github
- 新建一个摘要存储库(我的叫做 bookmark-summary),并在其中添加一个空的 README.md 文件
- 将 process_changes.py 添加到摘要存储库,用实际的存储库名修改
BOOKMARK_COLLECTION_REPO_NAME和BOOKMARK_SUMMARY_REPO_NAME;如果需要的话,可以调整summarize_text和one_sentence_summary中的 prompt - 回到书签存储库,将 bookmark_summary.yml 添加到
.github/workflows/bookmark_summary.yml,用Github账号/书签存储库名替换 22 行jerrylususu/bookmark-collection,用Github账号/摘要存储库名替换 27 行jerrylususu/bookmark-summary - 新建一个 PAT(Personal Access Token)
- 入口:Github 主页 - 右上角 Settings - 左侧列表底部 Developer Settings - 左侧列表 Personal Access Token / Fine-grained Tokens - 右侧 Generate New Token - 验证密码
- Token Name: 随便写
- Expiration:可以长一些,但是不能超过 1 年
- Repository access:选 Only select repositories,然后在下面选中自己的摘要存储库
- Permissions:点开 Repository Permissions,找到 Contents,选择 Read and write;其他不用动
- 点击底部 Generate Token;Token 只会显示一次,复制下来保存好
- 回到书签存储库,添加密钥到环境变量
- 入口:书签存储库 - 顶部 Settings - 左侧 Secrets & Variables / Actions - Repository secrets - New Repository Secret
- 需要添加 4 个(其实有的可以放在 Environments 里,不过这里我为了方便先全放到 Secrets 里了);冒号前面的是名字,冒号后面的是内容
- PAT :第 5 步生成的 token
- OPENAI_API_MODEL : 模型名,如 gpt-4o-mini;如果像我一样用 deepseek 则填写 deepseek-chat
- OPENAI_API_KEY : API key,通常以 sk- 开头
- OPENAI_API_ENDPOINT : 模型 API 地址,留空默认用 OpenAI 官方;可以填中转站;用 deepseek 则填写
https://api.deepseek.com/chat/completions
- 至此应该配置完成了。可以用 osmos::memo 扩展添加一个书签试试,观察书签存储库中工作流是否正常运行,摘要存储库中是否生成了对应的摘要。
勘误
- 感谢评论区 a1032077316 指出「我也想要一节」中的部分步骤错误,已经在文中修复
6 - 工作两年了
从我 22 年 8 月开始参加工作以来,已经过去了两年的时间。我自己也马上就要 25 岁了。决定还是写点什么东西记录一下。本文可能没有什么结构,只是想到什么写什么;另外出于众所周知的原因,无法详细描述具体细节;还请各位读者见谅。
总体感受:7/10
- 工作稳定性
- 虽然目前看还算稳定,但是因为个人强烈的风险厌恶偏好,自己依然以”明天可能就会失业“的态度进行财务规划;体现为对长期大额负债(如房贷)的拒绝,和对现金流、资金灵活性的强烈偏好(如货币基金占比较高)
- 任何时候离失业只差一次重大事故;至今的工作生涯中已经第一次出现了产生资金损失的事故,虽然不是自己直接造成的,但是也有一些自己的间接原因
- 自己对事故的态度比较悲观:事故总会(eventually)发生,只是或早或晚的问题;我所能做的,只是尽我的能力尽量推迟其发生,或是减少影响程度罢了
- 工作内容
- 主要是 keep the lights on
- 日常处理一些杂活,参考和优化现有的 SOP
- 作为团队对外的 point of presence,接收其他团队的咨询,如果处理不了就拉更高级别的同事上升
- 减缓团队内其他更高级别工程师的压力,分担事务性或者紧急但是技术上不复杂的工作
- 也作为一些小项目的交付负责人,主要是一两个月内就能交付的短期项目(我认为自己当前的规划和沟通能力也不足以支撑更大的项目)
- 全栈:cpp 内部服务、vue2/typescript 内部CRUD站点、python/sql 数据任务和数据分析
- 虽然说是cpp,但是其实基本不太会用高级特性,大部分事情rpc框架就处理了,更像是go/java写业务需求的感觉;对底层的了解不够深入
- 一个人完全负责某个特定模块,的确能极大降低沟通成本
- 主要是 keep the lights on
- 工作体验
- 目前进入一个比较顺利的状态,日常的工作大部分在舒适区内,小部分有挑战性
- 已经建立了对组内负责系统的心理模型 mental model,例如能大概说出请求从进入到返回,会经过哪些模块(类似于原来是RAG,现在是直接fine tune了)
- 对部门、公司的基础组件、框架有了一定了解和使用经验
- 被认可作为团队战力的一部分;但是有些事情目前只有自己在完全负责,虽然有理论上的备份负责人然而没有切换过,有些担忧
- 团队关系正常
- 日常工作交流都很正常(虽然自己不会和同事一起吃饭)
- ld人比较好,会批临时请假,但是感觉压迫感有些强,有的时候性急会上压力(不过可能能做到这里的管理者都是如此?)
- 基本做到工作生活平衡和分离
- 工作时间 10am - 8pm,除去午休和晚餐,纯工作时间基本有 8h;然而通勤比较远,实际出门和到家的时间是 8-9;但至少可以保证双休,已经比很多中小厂好了
- 周末基本不处理公司事务,紧急事情电话通知;目前还没有周末物理去公司加班过(虽然偶尔要从家里远程加班),期望可以继续保持不加班
- 天气适合时(not 冬季)的中午保持运动
- 之前有些架构变动,被调去支援其他数据系统,半夜 oncall 十分难受,人真的会崩溃,好在后面出来了
- 开发者体验 devex 尚可,但还有改进空间
- 有基本的 CI;业务重要所以没法 CD,但是发布频率足够高
- 治理任务分配系统很有用(虽然作为处理人也很烦人)
- 单元测试应该更多(现在感觉不太够,至少有些重要的点的覆盖率我自认为肯定是不够的)
- UAT测试有但是用处存疑
- 监控系统还不错而且一直在改进
- LLM 用于开发和代码评审
- 目前进入一个比较顺利的状态,日常的工作大部分在舒适区内,小部分有挑战性
- 职业发展
- 升职顺利
- 从入职到现在还算顺利,每个可以升级的节点都升级了
- 最近的一次升级感觉有些得不配位,另一位和我同期进来的同事,我认为做的比我更好(甚至周末还来加班)
- 感觉更高职级的更惨:压力大、开会很多、周末还要加班处理事情(还有晚餐后和家里的小孩视频电话,听起来就很…);现在的职级反而比较舒服,会也比较少,可以安心写代码
- 绩效和薪资还算满意
- 去年拿了一次好绩效
- 入职的时候 base 比另一个 offer 低很多,且房补在跳槽时很多公司不认可;好在最近薪酬改革后房补融入了 base,且职级提升也对薪资有影响,总算是比 2 年前的另一个 offer 的 base 高了
- 年终奖不是在当年发放完,而是拆到多年发放,有些坑(算是把你拴在这里了)
- 既然现在还不错,能撑多久算多久吧(Enjoy it while it lasts)
- 跳槽前景不佳
- 基本上都在写业务逻辑,疏忽了对框架底层和技术的投入
- 虽然考下了软考高级系统架构设计师证书,但是在私企的用处不大
- 目前的业务已经是国内头部了,未来要跳的话如果同一方向则可选非常少
- 希望能看看大模型相关的机会,但是知识缺失 gap 太多了,不知道从哪里补起来
- 升职顺利
7 - 软考高级架构师备考记录
我参加了 2024 年上半年(5 月)的软考(全称:全国计算机技术与软件专业技术资格(水平)考试),通过了高级资格「系统架构设计师」的考试。本文记录我的备考过程。
个人背景
科班 CS 本科,参加工作 2 年,大厂底端程序员。
参加软考的原因
如果回看我的 23年总结&24年展望 的话,会发现当时我已经把通过软考作为 24 年的个人目标之一了。其实我接触软考是 23 年 9 月,但是了解信息有些延迟,当时已经过了报名窗口,所以只能再等半年。当时我并没有非常清晰的动机,以下列出的原因只是站在考完的时间节点上反向硬找出来的:
- 学生时代的考试思想延续:作为中国学生,考试思维估计是我思想中比较难剥离干净的一部分了,核心是将各类难以量化的目标想方设法量化,并且制定明确的验收标准(例如通过考试)来催促自己达成目标
- 学习架构设计:虽然我接受了科班教学,也做过不少项目(无论是学生时代还是工作之后),但是大部分情况下,架构要么是直接给出(例如更高级的同事已经设计好了),要么是自己瞎整(例如各类课程项目),没有系统性学习过;既然刚好有”系统架构设计师“这个资格科目,作为考试也有系统性的知识梳理,不妨以考促学
- 为未来发展留点余地:虽然目前在私企工作用不上,但是未来无论是跳槽国企还是润其他国家,软考的证书认可度还是可以的(e.g. 软考在日本永居打分接受的证书列表中)
- 退税:考过了的话可以
退税 3600 元(8/7 评论指正:是 3600 元的退税额度,实际退税金额取决于税率)(每个税收年度可以在继续教育类目下认证一个资格类证书) - 听起来比较厉害:毕竟叫做高级,能满足下虚荣心 当然每个人可能还有其他的原因(例如落户、国企内评职称、所在地域有优惠政策…),不过我自己的原因大致就是以上这些了。
但决定参加前,也必须要了解软考的局限性:软考本质上还是个八股文考试,有很大可能学了用不上(毕竟对于考生的工作年限是没有要求的);而且软考是水平考试而不是资格考试,做开发也没有任何资格壁垒(不像建筑)。
软考的考试内容
既然是考试,最重要的当然是考什么。好在这个问题并不难回答,看教材就好了。架构师的教材名叫《系统架构设计师教程(第2版)》,大体上可以分为两个部分;第一部分是综合知识,其中一些章节接受过科班 CS 教育的人稍作复习即可(计算机系统、信息安全、数据库设计),另外一些章节则之前学的不够深入或者是首次接触,需要学习(软件工程、架构设计、质量属性、软件可靠性、架构演进);第二部分是各类架构的详细介绍,总共划分了八大架构(信息系统、层次式、云原生、SOA、嵌入式、通信系统、安全、大数据),每个架构内会有概述、设计、优缺点、适用场景、示例等。
和考试内容同等重要的,还有考试形式。软考高级资格的考试是 3 个科目:综合知识(单选,75题)、案例分析(简答,1必选+4选2)、论文(4选1,2k字+)。(是不是有种高中语文的感觉了?)每个科目满分 75 分,及格线是 45 分。所有科目都及格才能通过。其中综合知识和案例分析上午连着考,论文则是下午单独考。每个科目的考试时间都是 2 个小时。这其中综合知识和案例分析,基本上靠刷题可以覆盖掉,然而论文就是一个大坑了,毕竟2个小时时间,要完成选题、构思、写作、检查,而且字数还要求2k以上,如果没有训练过实在是比较困难。(顺带一提,23年下半年之前,软考是纸质考试,论文当然也是要手写的;好在23年下半年开始改为了机考,论文也可以打字作答了;真不敢想象之前的考生是如何考过的)。
备考资料
我认为比较有用的资料有:
- 书《系统架构师设计师考试 32小时通关》(作者:薛大龙):基本上是教材的精简版本,还带有简单的例题;初期可以先用这本书读一遍,建立下知识框架(软考官方教材不要买纸质书,又厚又重;找 PDF 就够了)
- 软考备考资料:https://github.com/xxlllq/system_architect;虽然 repo 里有些东西,但是大部分资源还是要付费后从阿里云盘获取;虽然这些资料自己逐个找也可以找出来,但是相对于花的时间和精力来说,花点小钱(¥20)一次找全还是划算的
- 小程序《软考达人》:刷题用(综合知识和案例分析);单纯刷题的话完全免费,不需要付费也不用加群
- B站视频课程(up 主:文老师软考教育):https://www.bilibili.com/video/BV1Dy4y1a71j;时间比较紧,就看了论文的两 P,对梳理论文结构很有帮助(e.g.十段式)
总体上,最必须的书 + 资料大概五六十元就可以拿下;是否要买课或者是报班就见仁见智了。
备考时间线
基本上备考时间只有 2 个月,核心的学习时间大概是 60 小时(18 小时读书建立框架、30 小时刷题、12 小时考前临时抱佛脚)。
- 报名:2024/3/25
- 建立框架:2024/4/4 ~ 2024/4/6,趁着清明假期,把 32 小时通关读了一边,顺带做了下书上的例题
- 综合知识刷题:2024/4,基本上是上班的地铁上刷题,一开始刷综合知识的选择题,到了4月底,基本上能保证在40分钟内完成且分数高于及格线了;这一阶段硬刷就是了,很多知识点都是边刷边熟悉的,错了也不用太担心,下次还会遇到的
- 案例分析刷题:2024/5,也是在上班地铁上,小程序的题库量比较少(120题左右),但是案例分析比选择复杂很多,所以可能一天只能刷个三四题;我自己的做法是先读题,自己想怎么回答,然后看参考答案,根据参考答案补全自己的答案(因为不方便用纸笔,基本上都是脑内过一下就完了)
- 考前抱佛脚:2024/5/24(考前一天);因为一些工作上的调整,5月开始每周的工作量都很大,周中已经很累了,周末也完全提不起精神去学习;眼看着马上就要考试了,报名费还挺贵的,这次没过还不知道是否有自信再来一次,思来想去还是考前请了一天假,去图书馆专心复习,能复习多少算多少吧;最后这一天从早9点一直学到晚上10点图书馆关门,虽然不确定学进去多少,但是至少心态上自信多了
- 错题整理:过了下之前刷题阶段的错题,一些知识点回到教材重新梳理知识脉络,编一些自己能记住的记忆口诀(例如 六大质量属性 APTSUM:A可用性 P性能 T可测试性 S安全性 U易用性 M可修改性)
- 看论文网课:说来惭愧,之前一直都没写过论文,于是先B站找了个网课看下(就是上面备考资料写的),了解了十段式(项目概要+正文概要+项目背景+项目组成+子题目回应+正文论点3+总结+不足)
- 写一篇论文:学完了论文结构之后,就立刻写了一篇试试看(不然一篇没写过上考场准完蛋,写一篇可能还有点盼头);题目是随便想的,考虑到 LLM 发展如火如荼,自己定了个《大语言模型和人工智能技术在软件系统开发中的应用》的题目;然后就努力花了 4 个小时憋出了第一篇论文,对照着论文网课还有其他资料中的论文范文又继续改了改;然后整理了所有押题的论文题目,想自己的项目怎么套上去
- 考前资料整理:把认为考前需要复习的内容(常错的知识点、案例分析套路、论文架构、自己瞎编的论文)拼成了一个文档打印出来,考前背诵用,也安心一些
- 考试:2024/5/25
- 综合知识:有些点忘了,有些完全没见过,但是好在之前刷的题够多,75 题中自己完全确定答案一定正确的就有 48 题,这部分应该是稳了
- 案例分析:必选题是质量效应树和微服务架构,开考前刚背过;4个自选题选了大数据(mongodb、nosql)和 UML 时序图,剩下的两个(嵌入式和分布式锁)感觉不太稳没敢选
- 论文:题目有模型驱动架构设计、单元测试、云上自动化运维、大数据lambda架构;刚好最近在做一些数据系统的工作,于是选了大数据lambda架构的题目;内容上虽然参杂了一些工作上的技术,但是主体大部分还是瞎编+课本知识的混合
- 查询成绩:2024/6/24,通过,综合知识 56,案例分析 52,论文 52;只能说运气很好,论文编的合判卷人口味了
- 领实体证书:2024/7/25

感受和建议
- 对于科班 CS,有实际开发经验的同学来说,这个考试并不算非常困难(10分最难的话,大概是7~8分的水平),但是依然要花时间准备(主要是刷足够多的题)
- 论文真的很看运气,本次是运气好,可选的题目里有一个和我最近的工作相关的题目;如果没有这个题目可能我就跪了;最好要掌握如何把自己做过的项目套到论文题目上
- 写作速度很重要,论文的 2 小时我基本上前 5 分钟在选题和构思,后面就一直在写了,结束前 2 分钟才完稿,时间非常紧张
- 如果你是学生,有比较多的空闲时间,不妨去考下试试看,反正也不要求工作年限
和正文无关的一些碎碎念:上次写考试相关的文章,还是 2021 年 7 天 TensorFlow 开发者认证的那一篇。那篇文章意外上了阮老师的周刊,还给本博客增加了不少流量。现在回过头来看看 ML 领域 PyTorch 几乎已经一家独大,TF 如风中残烛,更别提 LLM 的突飞猛进,当年的认证回头来看其实除了满足虚荣心+能写在简历上之外,并没有起到实质性的作用。前几天收到 Google 的邮件,说当时考的认证已经过期了(有效期只有三年),问我还要不要再续(实际上就是再考一次),那当然就选择不考了。虽然软考没有有效期,不存在重考的问题,但在决定投入精力被考前,依然得好好想想是否真的「对我有用」。
本文发出后的修正
- 修复了关于退税的表述(2024/8/7)
- 修了错误的日期描述;“基础知识”改为“综合知识”;补充证书图片(2024/8/9)
8 - 2024 年了,我最近在用什么工具
2024 年了,我最近在用什么工具
去年年中,公司的主力开发设备从 Windows 换成了 Mac,之前在 Windows 上用的各类工具需要重新在 Mac 上找对应的替代品。一年磨合下来现在已经差不多稳定了,特此记录(其实之前就应该记录的,但是太懒)。如果能帮助到各位读者就更好了。当然也欢迎评论推荐更多你认为好用的工具。
独立工具
(此处的独立指的是软件本身可以独立运行,与之相对的是插件)
- VS Code:宇宙 IDE(装了足够多插件之后)
- Kate:KDE 家的文本编辑器,功能齐全但是又没有 VS Code 那么重,临时处理些文本比较方便;之前不支持 M 系列处理器,2024 年初更新后总算支持了
- CudaText:用来当作思维 buffer,优点是自带置顶(其他软件都很难做到)和自动保存,目前已经开了 100+ Untitled Tab 了但是依然很稳定
- Apple Notes:用来记录手头临时的待办事项,避免消息太多跟丢
- Obsidian:用来做工作笔记,其实就是对每个任务建一个文件,然后把所有相关信息全部丢进去;偶尔也用用 canvas 功能
- Utools:小工具聚合器,例如 JSON 格式化、二维码生成、base64编解码、timestamp 生成和解析、变量名大小写转换;绑定到 Opt+Space
- RayCast:主要用来窗口切换和左右分屏,其他的功能用的不多;绑定到 Alt+Space
- Snipaste:截图 & 贴图是我工作流的重要部分,已经完全离不开了
- Karabiner-Elements:之前从 Windows 切换过来的时候用于改键(左 Ctrl -> 左 Cmd);现在键位熟悉之后用的不多了
- Hidden Bar:隐藏托盘区域的图标(这居然不是 OS 自带的功能?Windows 用户理解不能)
- Maccy:剪贴板历史(救了我好几次)
- Stats:用来显示内存占用(可能和我的用法相关,虽然已经是 32G 内存的配置了,但是使用超过一周依然会有内存泄漏,内存压力红了之后只能重启)
- UnnaturalScrollWheels:修复外接鼠标滚动方向相反的问题(我觉得这也应该是个 OS 级别功能)
- Draw.io:画各种图
- EasyFind:Windows 文件搜索工具 Everything 的 MacOS 下位替代,但是总比没有强
- Timer:倒计时小工具,拟物风很棒;用来提醒我该在发布单上点击下一步了
- MacZip:用了这么久 Mac 还是不能适应双击压缩文件自动解压的逻辑,还是能先预览下压缩包内容比较好
- Insomnium:类 Postman 工具,但不用登录在线账户,local-first;虽然已经停止开发,但是功能已经足够齐全了
- ActivityWatch:记录下今天上了多少班
- Chatbox:最好用的 OpenAI API 客户端,支持刷新上下文、显示 token 用量、消息修改、消息重放(btw 自认为目前用下来综合表现最强的 LLM 是 deepseek-coder,便宜大碗也足够智能)
Obsidian 插件
- Electron Window Tweaker:让 Obsidian 窗口也能够置顶
- Git:自动把变更提交到 Git 库,避免数据丢失(我设置的是 10 分钟一次);另外偶尔看看 blame 还有成就感(原来这个文件已经被我改了这么多次了)
- Tasks:将所有文件里的任务收集起来,创建统一的任务视图
- Vertical Tabs View:标签页太多的时候,可以用纵向列表列出所有标签页(也和我 Edge 的使用习惯一致)
- [New Tab +]:避免同一个文件被打开在多个 tab 中
- Another Quick Switcher:解决 Quick Switch 时,默认搜索结果是按照文件名排序而不是最近修改时间排序的问题
- Unique Note Creator:官方插件,可以直接创建一个带有时间戳的笔记并应用模板;用来在出现新工作时创建对应的工作笔记
(顺带一提,为了和 VS Code 使用习惯一致,Quick Swtich 绑定到 Cmd+R,command palette 绑定到 Cmd+Shift+P)
浏览器插件
(目前用的是 Edge,纵向标签页没有其他浏览器支持)
- 沉浸式翻译:外文长文必备
- ModHeader:调试用,主要拿来改 request header
- Inssman:调试用,主要拿来该 request body(其他的相关插件,例如 Requestly 似乎都要求登录)
- Earth View From Google Earth:在新标签页展示航拍景象,换换心情
- Page Notes:可以保存和某个域名/ URL 相关的笔记;我自己的用法主要是在日志查询页上放一些常见的查询条件,省的来回翻找
- Picture-in-Picture Extension (by Google):画中画插件,
<video>tag 的视频都能用,摸鱼必备 - Session Buddy:定时备份打开的标签页,对我这种日常 100+ tab 的用户很友好
- VerticalTabs:在 tab 之前切换(但后来发现 Cmd+Shift+A 更好用);现在只是用来显示打开 tab 的个数,超过 150 了就得关一批
- TamperMonkey:针对内部不好用的网站,写了很多 JS 小脚本来改善用户体验
还有些小工具网站:
- JupyterLite:一个基于 WebAssembly 在浏览器内运行 Python 和 Jupyter 的环境,临时写点东西或者调试都很方便
- Day Tracker:之前自己写的小工具,看今天还要上多久班
VS Code 插件
- Bookmarks:可以给特定的代码行加书签;大代码库或者是逻辑拆的太碎的时候需要
- Error Lens:行内显示报错信息,不需要手动在波浪线上 hover 也能看到
- Todo Highlight:将所有 TODO 高亮出来
- GitLens:和 VS Code 自己的 Git 能力配合使用,就再也用不上其他的 Git GUI 了;行内 Git Blame (浅色文字显示这一行上次的修改来源)和 File History (和该文件相关的所有 commit)很有用
- Live Server:改 HTML 的时候可以临时起个服务器,文件修改后自动刷新
- Git Graph:GitLens 的分支图是收费功能,可以用这个插件替代
- indent-rainbow:缩进可视化
- Stats Bar:显示机器状态(CPU/内存/网络);主要用来看云开发机的内存是否又爆炸了
- Template String Converter:写 TypeScript 必备,输入
$且时自动把当前字符串变量的"(一般字符串)换成`(模板字符串)
9 - End of 2023
End of 2023
一转眼又到年底了,关注的博主和身边的好友纷纷亮出了自己的年终总结;在这个离跨年还有2个小时不到的时刻,决定还是随手写点,就当给未来的自己留下些印象了。
回顾 2023
- 工作
- 正常升了一级,工资涨了点;但相应的工作量也增加了很多
- 可以明显感觉到自己不再被视为新人,而是已经成为了部门战力的一部分
- 对负责的业务的复杂性有些感觉,但是了解的依然不够深入;简单的问题可以处理,复杂的问题还是得拉人一起看,没法自己独立解决
- 全年负责的部分没有出大事故,但是总感觉有些不安
- 开始有完全自己设计的内部系统了,运营也是自己负责
- 作为新人参与的第一个项目(参加1年+被交出去),有些不舍
- 接近年底的时候接了个很重要很紧急的活,被迫打破自己内向的一面到处找人推进进度,算是体会了一把成为项目owner的感觉
- 部门内年中、年末各出现一次大范围组织架构调整,自己所在的小组目前还尚存;同届进来的新人被优化,后续又找到了更好的新工作;自己也应该考虑这方面的可能性了
- 干起来还行,虽然不算特别好,但是也不坏;至少可能会先一直干下去,直到哪里突然出现重大变化
- 生活
- 依然住在家里,通勤时间是个比较困扰的问题,但是自己出去租房外短时间内应该无解
- 3月眼睛不舒服检查发现左右眼近视远视度数差距过大,开始戴眼镜,估计很长一段时间内都会持续了
- 7月检查发现胰岛素抵抗(糖尿病前期),开始定期运动,后来选到了每天中午,边运动边看一集番,从7月开始到12月初天气寒冷结束,中间因为11月生病停了两周,总体运动天数应该在100+
- 中午开始不吃公司食堂,成为附近kfc常客,备注不加酱多加菜(这样算下来午餐的热量摄入其实还更低)
- 10月去日本旅游了,算是满足了一个自己长久以来的愿望
- 开始固定时间去公园散步(以深圳湾公园为主),以及定期的群友聚餐;对维持精神状态有很大帮助
- 年初的时候用微信读书读了几本书,但是后续没有坚持下去;年末的时候买了《计算》,抽空读了一小部分,感觉还是跳着读自己感兴趣的部分比较合适
- 重新开始学习日语(虽然之前硬背的五十音基本已经完全忘光了)
- 技术 & 开源活动 & 探索
- 工作中实际使用的技术(后端 C++ / Node.js + TypeScript,前端 Vue,数据处理 Python / SQL)基本保持同等水平,C++ 可能是稍微了解的多了一些
- 手里的几个开源项目依然处于维护状态,没怎么写新的(除了年底的 mainonly)
- 参加了一次国内的 Linux 中国活动,感觉大家都还挺害羞的,主题还有点意思但是运气不好没抽到奖
- 探索各类 AIGC 工具,目前来看处于初步成熟阶段,可以做些事情但是能做的依然不太多
- GPT:因为价格和付费渠道问题主要用 API,日常 3.5 基本够用,不行的话再上 4-turbo;如果只是问代码问题的话 Github Copliot 的体验更好,响应也更快(虽然 $10/月 也不算便宜就是了);至少编写一些基本代码,或者处理某些特定疑难点已经很够用了
- 其他 LLM:通过 OpenRouter 试用了 Claude / Gemini / Mixtral 的 API;Claude 对于长文很好用但是最近启用了 geoblocking 没法用;Gemini 用字符数计费有些神奇但是用起来和 3.5 感觉差不多;但是 GPT 效果实在是太好,用其他模型的意义不大;还试用了一些国内的 LLM,如智浦的 GLM 系列,百川的 Baichuan 系列,对于中文来说体验更好,另外因为词库以中文为主收费也更低
- SD/MD:MD 类用自然语言就可以出很惊人的效果;SD 自由度很好但是上手比较难,估计得熟读各种咒语 + 自己有足够多的时间体验
展望 2024
- 工作
- 正常升级 + 不出事故,至少先活过入职两年的分界线
- 需要开始了解市场状态,重新开始面试准备了,至少万一被优化还有备选
- 生活
- 回暖之后可以坚持运动;体重降回正常范围
- 每个季度读一本工作无关的书
- 学习日语到N2水平
- 考过软考
- 投资学习 & 实践:阅读相关书籍,尝试用收入的 10% 进行一些多元的投资操作
- 技术 & 开源 & 探索
- 了解和学习之前没接触过的技术:React / Vue 3 / Next.js / SSR
- 用 Rust / Zig 写些小项目
- 把五十音工具改造成微信小程序
- 对图像生成类工具有更多了解(至少玩起来)
10 - 再次复活(2023)& 换用 Github Action 部署
又是很久没更新博客了,看了看记录上次更新已经差不多是一年前了。和上次一样,这一年中依然发生了很多:完成了硕士学业,解封前跨过重重关卡回国,入职,打工一年… 真正开始工作的感觉和还是学生时的预期差不多,如果非要比较的话虽然没有大学这么轻松,但是比高中还是好多了的,况且还有钱拿?不过这是后话了,之后再慢慢展开吧,可能以后会有一篇更长的文章来总结这一年(又在挖大概不会填的坑了)。
本次主要的变更是把原来的手动发布流程转换成了 Github Actions,之后直接在 master 分支下提交文件,就会自动触发部署流程,大大减少了阻碍。(对比之前的流程:写文章 - 本地构建 - 复制到部署文件夹 - Git 提交)实际实现起来也很简单,将所有的构建产物(实际发布的静态文件扔到另一个分支 publish),修改 Github Pages 的来源分支,然后写点 Github Action 配置就好了。希望通过让发布的流程更简单,未来可能也会逐渐多写点东西吧。(美好的愿望…)
顺带一提,本次迁移的时候其实尝试过用最新的 Hugo 版本来部署(v0.117.0),但是构建过程中出现了很多模板相关的错误,估计是目前用的 Manic 主题使用到的某些 Hugo 特性已经被 deprecated 了。看了看原始的 Manic repo,最后更新也已经停留在好几年前了。之后要是有空的话可能会试着解决(或者再换一个主题…),不过这次就先暂且继续用旧版本 Hugo 来构建吧。
11 - 将已有的 Vue App 变为 PWA
之前写过一个用来辅助五十音记忆的小 App: Gojuon Quiz (源代码),最近心血来潮决定给它加上 PWA (Progressive Web App) 功能,这样一来用户首次加载成功后,后续就算没有网络也依然可用,二来打开的时候不会显示浏览器地址栏之类的控件,体验上基本和一个原生应用接近了。
具体操作起来其实很简单,基本上就是以下几步:
- 安装 Vue PWA 插件:
vue add pwa - 生成不同大小的图标,放置于
img/icons下:可以用 Real Favicon Generator - 在
vue.config.js中稍微调整下 PWA 插件的配置:可以参考 @vue/cli-plugin-pwa 文档 - (可选)增加更新提示:参考 Handling Service Worker updates in your Vue PWA
不过不做这一步也不会影响自动更新功能,只是需要更新完成后用户手动关闭再重新开启,才会应用新的版本。
安装完成后,可以看到以下标志,证明 PWA 功能成功配置了:
- Chrome / Edge 地址栏右侧出现加号
- console 输出 service worker 相关调试信息
调试的时候有一些小问题需要注意:
- PWA 在开发模式(如
vue serve)下是不会启用的,需要先vue build之后,手动在 dist 目录下开一个 HTTP 服务器(可以用 `python -m http.server)才会启用。 - 如果是用局域网的设备,访问开发机上的 HTTP 服务器,也可能无法触发 PWA。原因是 PWA 触发需要 HTTPS(或服务器在本地 localhost)。
- PWA 自定义名称的话,需要写在
pwa.name下,而不是其他内层结构里。(之前装了i18n插件,习惯性的写到pluginOptions里了。)
12 - Python `itertools.permutations` 使用的排列算法
TL;DR:这本质上是一个基于回溯,利用元素交换的递归排列生成算法,但被重写成了循环形式(可能出于效率考量)。
引子
最近在算法复健,刷到了排列相关的题目。恰巧 Python 内置了一个非常实用的工具库 itertools,其中有一个 permutations(iterable, r) 方法,可以对一个给定的 iterable 生成所有大小为 r 的排列,且输出按照字典序排列。
在我之前所接触的算法中,排列生成要么是基于回溯,要么是基于字典序,但无论哪种都只能生成全排列,而无法生成这样的部分排列(指生成的排列长度 r 和原输入长度 n 不同)。另一条思路是先生成所有长度为 r 的组合,然后再在每个组合内生成全排列,但这样无法保证输出按字典序(除非先手动收集再排序)。
于是我打开了 Python 的 itertools 的官方文档,其中提供了与 CPython 实现等价的 Python 代码,permutations 方法的代码如下(🔗):
尝试初步理解
虽然顶部有两行注释,不过这也只是描述了这个方法的效果,对其原理并没有任何解释。往后继续看,可以发现算法首先构造了两个 list:indices 和 cycles,且之后每次输出结果(yield)实际上都是将 indices 中的前 r 个输出。再往后算法进入了一个神秘的 for 循环,对 cycles 中的元素做了一些修改,用 cycles 的值对 indices 中的一些元素做了交换。仅从代码层面出发,对算法的理解似乎也就止步于此了。然而这并没有回答一个重要问题:为什么这个算法能工作?
寻找相关信息
考虑到 itertools 库是在 Python 2.3 (2003 年 7 月)被引入标准库的,这个算法已经算得上历史悠久了。再加之 itertools 库的广泛使用,这个算法的原理应该是早已被详尽记录的。带着这样的期望,我开始用各种关键词组合搜索相关信息。可惜的是,除了 Stack Overflow 上一个 2010 年的问题(🔗),和一个知乎提问(🔗),就没有任何其他相关的网页了,甚至连当年的提交记录都找不到。
既然如此,那就只能从这两个链接入手了。
- Stack Overflow 的答主 Alex 写了一篇长文回答,但一开头就说「你需要理解 Permutation Cycle 的数学理论,才能理解这个算法」。于是我又回头恶补了一番组合数学,然而就算我大概知道 Permutation Cycle 是怎么一回事,对这个算法依然毫无头绪。(评论中也有人自称有 6 年抽象代数经验,但不认为这个算法与数学相关。)不过 Alex 的回答提供了一些有用的直觉,至少读完这个回答我大概理解
cycles在算法执行过程中是如何变化的了。具体而言,cycles的变化类似于「倒计时」,或者说「带借位的减法」,每次最后一位到 0 时,就会触发前面的一位减 1。然而我对indices的变化依然云里雾里。 - 知乎提问中,答主「杨个毛」提供了一个看起来很有说服力的回答(剧透:而且也的确如此):「那个代码可以看成下列递归程序的强行非递归版」,指出了
cycles是变进制数,并提供了一个原始递归版本。可惜的是,对于这个算法为什么可以输出正确结果依然没有解释(也有可能是我没有完全理解)。
自己来
已有的信息似乎不是很充分。看来我只能自己来了。在加了一堆 print 并在纸上手动模拟了多次这个算法之后,我认为我可能大概理解它的工作原理,并且可以证明其正确性了。下文将详述我的理解。
算法
起步
开始前,需要统一一下后文使用的记号:
n代表输入 iterable 的长度r代表输出的排列元组的长度
并回顾我们先前阅读算法得到的理解:
- 对输入的
iterable会遍历其所有元素并放在pool中 - 每次算法输出结果(
yield),实际上只是取了indices列表的前r个 index,并输出pool中的对应元素。
我们将按照如下步骤理解这个算法:
- 理解
cycles的变化 - 理解
indices的变化,并尝试说明这个算法的正确性 - 尝试重新实现这个算法的「原始」递归版本
cycles
我们首先从 cycles 变量入手,理解它在这个算法中是如何变化的。这个阶段我们暂时先不考虑 indices。
可以先指定一些具体的输入,然后尝试加一些 print 语句。以 iterable="ABCD", r=2 作为输入,在 if 和 else 两个分支执行前后中都插入 print,可以得到如下结果:(其中中括号说明算法有输出 yield,大括号部分算法无输出)
我们可以直观感受到,似乎 cycles 变量就像一个「倒计时」,或者说「带借位的减法」。
- 一开始
cycles[0]被初始化为 4,cycles[1]被初始化为 3。 - 之后的循环中,一般是
cycles[1]不断被减 1。当cycles[1] != 0时,算法会产生一次输出。 - 如果
cycles[1] == 0,会导致cycles[0](前一位)减 1,并将cycles[1]重设回其初始值 3。 - 最后当
cycles[0] == 0时,算法结束。
从这个具体的示例出发,我们可以这样理解 cycles 的变化:
- 一开始
cycles被初始化为range(n, n-r, -1),即cycles[0]=n,cycles[1]=n-1,…,cycles[i]=n-i。 - 之后的循环中,通常只有最后一个元素
cycles[r-1]在不断递减。如果cycles[r-1]递减后值不为 0,则算法会产生一次输出。用我们之前提到的「倒计时」类比,可以将这种情况称之为 tick。 - 如果
cycles中的某个元素(如cycles[i])为 0,会导致其前面的元素被(cycles[i-1])减 1,并将这个元素(cycles[i])重设回其初始值(n-i)。这一行为类似于倒计时中秒为 0 时会导致分减 1,并将秒重设回 0。继续用「倒计时」类比,可以将这种情况称之为 reset。
有了这一直观感受,就可以为 cycles 找出一个可能的解释(「物理含义」)了。我认为,cycles 代表的是 「每个位置上剩余的可用选择数」 。如果将 cycles 视作一个变进制数,则 cycles 也代表 「总体剩余还没有输出的排列数」 。理由如下:
- 一开始
cycles被初始化为range(n, n-r, -1),而可以计算出对给定的n,r所有的排列有P(n,r) = n*(n-1)*...*(n-r-1)种。 - 每次 tick,算法生成一个排列,消耗一个选择,
cycles[i]也减 1 - 每次 reset,实际上就是在
cycles这个变进制数上的借位减法 - 最后在
cycles上首位为 0 时算法结束,代表所有排列的选择都已经被消耗(输出)了,已经没有更多的排列了。
其实 cycles 的变化,无论是 Stack Overflow 上的回答,还是知乎上的回答,都有相对详尽的描述。在此我只是尝试以自己的语言重述了一次而已。但接下来对 indices 的理解就大部分是我自己的了。
indices
现在我们来看看 indices 是如何变化的。和之前对 cycles 的探索一样,我们也先从一个具体的例子开始:iterable="ABCDE",r=3,并关注一个子问题:前 3 个输出(ABC, ABD, ABE)是如何产生的。为便于展示,这里我直接使用具体元素(字母)代替 index。加了一些 print 后,我们可以得到如下的变化过程。
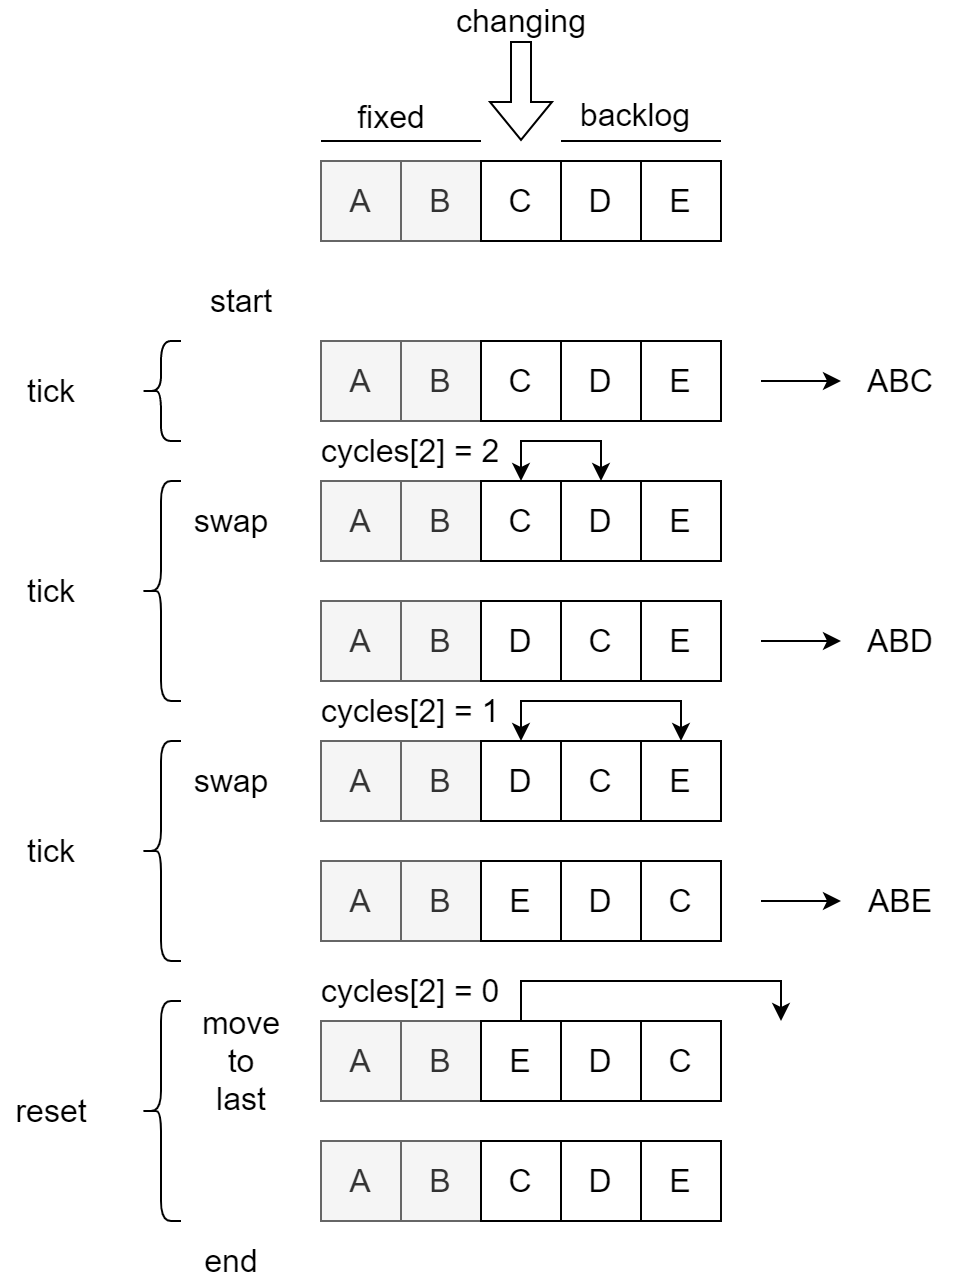
这个图稍微有些复杂。以下是进一步解释。
- 图的阅读顺序是从上至下,按照时间顺序展示了
indices列表的变化。左侧为各阶段具体行为的标注,右侧为算法输出。 - 这里选择展示前 3 次输出(即
i=2),对应cycles[2]从 3 到 0 的过程。别忘了每次进入循环前cycles[2]会被递减。 - 为方便描述,我们可以把
indices列表拆成 3 个部分:- fixed:
indices[0:1],在执行时不会变化 - changing:
indices[2],这是在不断被交换的元素,和 fixed 一起组成了算法输出(indices[0:2]) - backlog:
indices[3:4],这里存放着已经被使用的元素和还未被使用的元素
- fixed:
- 在每个 tick 中,changing 位置上的元素和 backlog 中的一个元素交换(
swap),并触发一次输出。可以注意到,交换前后 backlog 中元素依然维持其相对顺序。- ABC{DE} -> ABD{CE} -> ABE{CD}
- 注:这里将算法开始时的首次输出也视作一个 tick,因为进入循环前依然触发了递减,消耗了一个可能性。
- 相关代码:
indices[i], indices[-j] = indices[-j], indices[i]
- 算法结束前,一共触发了 3 次输出。这已经穷尽了固定前缀为
AB,最后一个可选项为C,D,E的排列。 - 在最后 reset 时,changing 位置上的元素被移到了 backlog 后(
move_to_last)。这一步完成后,changing + backlog 这个子列表(indices[2:4])恢复了和算法开始时一样的顺序。- AB{E}CD -> ABCD{E}
- 相关代码:
indices[i:] = indices[i+1:] + indices[i:i+1]
可以发现,这部分执行过程,恰好满足了回溯算法的正确性要求:
- 分步解决一个问题,每步中固定之前步骤的选择不变
- 算法执行中,遍历当前步的所有可能性
- 算法执行后,取消当前步的计算,退回上一步,选择下一个可选项
虽然图中仅描述了一个子问题(i=2,或者说i=r-1),但不难发现对于其他的 i∈[0, r-1] 这一讨论都是成立的。这也(不严格地)说明了这一算法的确可以遍历所有的可能排列。输出顺序为字典序,则是因为每个 tick 中交换元素时都维护了 backlog 中的相对顺序。
这部分讨论有些复杂,如果不太理解(或者不完全信服)的话,可以自己多加点 print ,或者手动在纸上执行感受一下。
重新实现
现在我们已经了解了这个算法的原理,重新实现其原始递归版本也就不难了。
- 递归调用时,需要一个参数指定当前修改的元素(changing)的 index
- 在每一层调用中,交换 changing 和 backlog 中的所有项,并在每次交换(做出选择)后触发下一层
- 如果 backlog 中的所有可选项都已经被选择(消耗)了,就把当前的 changing 移到 backlog 后,以撤销这一层的选择
以下是一个可能的 Python 重新实现。
递归转循环优化
出于性能和安全(防止爆栈)的考量,我们会想将这个算法的递归版本转换成循环版本。这需要我们用栈手动维护每一层递归的相关状态,包括递归中的变量和下一次执行的开始位置。幸运的是,对这个算法而言,我们需要维护的状态并不多。
r是已知且固定的,即栈的最大深度为r,因此可以用一个固定大小的列表来表示栈中(每一层递归)的状态。changing_idx是每层递归的输入,代表当前层变化的元素。changing_idx可以从栈的深度计算出来,栈底为 0,再上一层为 1… 因此实际上不需要维护。i或swap_idx为下一次交换的目标元素 index。这无法从栈本身的信息计算得到,需要我们维护。进入或重新回到当前层递归的开始位置,可以用
i或swap_idx推算得到:如果还有剩余可选项,则跳转到 tick;反之跳转到 reset
基于上文分析,可以发现我们需要维护的栈有两个特点:
- 长度固定为
r - 每个元素上维护下一次交换的目标元素 index
回头看看,这实际上就是 cycles。在「剩余可能数」的身份之外,cycles 也承担起了维护递归状态的职责。而作者巧妙利用了 Python 列表索引可以为负数从后往前的特性,统一了 cycles 的两面。
至此,我们完成了对这一算法的分析。🎉
相关链接
- Python
itertools.permutation文档:itertools — 为高效循环而创建迭代器的函数 — Python 3.10.4 文档 - CPython
itertools.permutation实现:cpython/itertoolsmodule.c at main · python/cpython (github.com) - Stack Overflow 相关问题:algorithm for python itertools.permutations - Stack Overflow
- 知乎相关问题:如何理解Python itertools.permutations中的全排列算法? - 知乎 (zhihu.com)
- 我给 Stack Overflow 问题写的回答:algorithm for python itertools.permutations - Stack Overflow
13 - (译) 复杂系统如何失效
复杂系统如何失效
译者注:在阅读 Slack Engineering Team 发布的 2022/2/22 事故报告时,注意到了这篇文章。作者描述了系统的复杂性为维护人员带来的挑战,并澄清了一些常见误解。个人认为这篇文章很有价值,但可惜暂无中文翻译,于是便自己动手了。本译文在 DeepL 机翻的基础上润色调整而成,错误在所难免,如有发现还请指正。
1. 复杂系统本质上是危险的系统
所有有趣的系统(如交通、医疗、发电),因其本身的性质,都具有固有的、不可避免的危险性。危险暴露的频率有时可以改变,但系统涉及的流程,依然具有内在的、不可减少的危险性。正是这些危险的存在,推动了防御措施的产生。危险和防御的存在也成为了这些系统的特征。
2. 对系统失效,复杂系统有大量成功的防御措施
随着时间推移,系统失效可能造成的严重后果,推动了多层防御措施的构建。这些防御措施不仅包括明显的技术部分(如备用系统、设备的「安全」特性)和人力部分(如培训、知识),也包括各种组织的、机构的、监管的防御措施(如政策和程序、认证、工作规则、团队建设)。这些措施如同一系列盾牌,通常会将系统运行导向远离事故的方向。
3. 灾难发生需要多重故障 —— 单点故障是不够的
一系列的防御措施是有效的。系统的运作通常是成功的。但当多个看似无害的小故障同时发生时,系统性事故才有机可乘,并最终导致显性的灾难性失效。尽管这些小故障中的每一个都是灾难的必要条件,但只有它们组合起来,才足以引发灾难。换句话说,系统可能失效(但没有失效)的时机,远比公开表现出来的系统失效多得多。大多数故障轨迹一开始就被系统中的安全组件阻挡了,而到达系统运作层面的故障轨迹,通常被一线工作者阻挡。
4. 复杂系统包含不断变化的潜在故障
这类系统的复杂性,使得它们不可能在没有多个缺陷存在的情况下运行。(系统中总是存在缺陷。)因为这些缺陷单独不足以导致失效,所以运行期间它们通常被视为次要因素。消除所有的潜在故障(是不可能的),主要受到经济成本的限制。另一原因是,很难在事故发生前,发现潜在故障引发事故的方式。此外,因为技术、组织和消除故障的努力的变化,这些潜在故障本身也在不断变化。
5. 复杂系统带病运行
基于前一点,一个必然的推论是:复杂系统像损坏的系统一样运行。尽管存在许多缺陷,系统之所以能继续工作,不仅是因为其本身包含了许多冗余,也是因为工作人员可以让它运行。事故发生后的回顾,几乎总是会注意到,事故发生前,系统就已经有一系列「原事故(proto-accident)」的历史。这些「原事故」差点就会引发灾难。一种论调认为,这些已经退化(降级)的运行条件,在事故发生前就应该被意识到,但这一论调是建立在对系统工作状况的天真认识上的。系统的运作是动态的,这一过程中系统的组成部分(组织、人、技术)不断失效又被替换。
6. 灾难总在拐角处
复杂系统具有灾难性失效的可能性。灾难可能在任何时间、任何地点发生,而一线工作者几乎总是在物理上和时间上接近这些潜在的故障。潜在的灾难性结果是复杂系统的标志之一。(从复杂系统中)消除这种灾难性失效是不可能的。由于系统本身的性质,失效的可能性始终存在。
7. 事后分析的「根因」根本上是错的
因为显性的失效需要多重故障,所以并不存在一个独立的事故「原因」。多种因素导致了事故的发生,其中每个因素单独并不足以引发事故,只有它们联合起来才足以造成事故。正是这些因素联系在一起,才创造了事故所需的环境。因此,不可能将某个事故的「根因(root-cause)」分离出来。事故评估中对「根因」的论证,并非出于对失效本质的技术性理解,而是出于将结果归咎于特定的、局部的力量的社会文化需要。[1]
[1] 人类学的田野调查为「原因」这一概念的社会构建提供了最清晰的证明。
8. 事后回顾中对人为表现的评估存在偏见
对结果的了解使人认为,对一线人员而言,导致失效的事件比实际情况显得更突出。这意味着对人为表现的事后分析是不准确的。对结果的了解阻碍了事后观察者重现事故前一线人员视角的能力,显得一线人员似乎「应该知道」这些因素「不可避免地」会引发事故。[2] 后见之明偏见仍然是事故调查的主要障碍,尤其是在涉及到人类专家的表现时。
[2] 这不是医学判断或技术判断的特点,而是人类对过去事件及其原因认知上的特点。
9. 人类操作者有双重角色:生产者和失效防御者
一线人员操作系统运转,不仅为了生产所需的产品,也为了防止事故发生。系统运行的动态性,即平衡为满足需求而生产和避免潜在故障,是不可避免的。外人很少承认这一角色的双重性。在没有事故发生时,生产的角色被强调。在事故发生后,失效防御者的角色被强调。无论在哪种情况下,外人的视角都误解了操作者对两种角色的同时参与。
10. 所有一线人员的行为都是赌博
事故发生后,显式的失效看似不可避免,而一线人员的行为则被视为愚蠢的错误,或对迫近事故的故意漠视。但所有一线人员的行为,实际上都是赌博,或者说,是面对不确定结果的行动。不确定性的程度可能时刻变化。一线人员的行为是赌博,这一点在事故后看起来很明显;一般来说,事后分析都认为这些赌博是糟糕的。但反过来说,成功结局也是赌博的结果,但这一点并没有得到广泛重视。
11. 棘手之处的行为消除了模糊性
组织对生产目标、资源的高效利用、经济和运营成本以及可接受的事故风险是模糊的。这一模糊性往往又是故意为之的。但一线人员在系统棘手之处的行动消除了模糊性。事故发生后,一线人员的行为可能被认为是「错误」或「违规」,但这些评价严重被后见之明偏见影响,而忽略了其他的驱动力,特别是生产压力。
12. 人类操作者是复杂系统的改造者
一线工作者和一线管理人员积极调整系统,以最大化生产和最小化事故。这些调整往往时刻发生。其中一些调整包括(1)重组系统,以减少脆弱部分在故障下的暴露。(2)将关键资源集中到预期的高需求区域。(3)提供从预期和意外故障中撤退或恢复的途径。(4)建立对系统性能变化的早期检测手段,以允许优雅地削减生产,或是其他增加系统弹性的手段。
13. 复杂系统中,人的专业知识是不断变化的
复杂系统的运行和管理需要大量的专业知识。这些专业知识随技术变化而变化,但也因为需要替换离开的专家而变化。在任何情况下,对技能和专业知识的训练和完善,都是系统本身功能的一部分。因此,在任何时候,一个特定的复杂系统将包含专业知识程度不同的从业者和受训者。和专业知识相关的关键问题来自于(1)需要将稀缺的专业知识作为资源,用于最困难或最苛刻的生产需求;(2)需要发展专业知识,以供未来使用。
14. 变化引入了新的故障形式
可靠系统中的低显性事故率,可能会鼓励变化,特别是对新技术的应用,以减少后果轻微但出现频率高的故障。这些变化可能实际上为新的、出现频率低但后果严重的故障创造了机会。当新技术被用于消除已经被理解透彻的系统故障,或是为了获得更高性能、更精确结果时,它们往往会引入新的、导致大规模灾难性失效的途径。并不少见的是,这些新的、罕见的灾难,甚至比这些新技术试图消除的故障影响更大。在事故发生前,这些新的故障模式难以被发现;大部分注意力被集中到这些修改带来的假定存在的有益特征上。因为这些新的、后果严重的事故发生的几率很低,在事故发生前可能引入了多个系统修改,使得人们很难看到技术对故障的贡献。
15. 对「原因」的观点限制了对未来事件的防御措施的有效性
事后对「人为错误」的补救措施,通常以阻碍可能「造成」事故的行动为前提。这些链条末端的措施对减少未来发生事故的可能性没有什么作用。实际上,因为潜在故障的模式不断变化,发生相同事故的可能性本身就已经非常低了。事后的补救措施,不仅没有增加安全性,反倒增加了系统的耦合度和复杂性。这不仅增加了潜在故障的数量,也使得检测和组织事故轨迹变得更加困难。
16. 安全是系统的特性,而非其组成部分的特性
安全是系统的一种涌现(emergent)属性;它不存在于一个组织或系统的某个人、设备和部门中。安全不能被购买和制造;它不是一个独立于系统之外其他组成部分的特征。这意味着,安全不能像原料或原材料那样被操纵。任何系统中的安全状态都是动态的;持续的系统变化保证了(系统中的)危险和对危险的管理都是不断变化的。
17. 人不断创造安全
无故障运行是人们通过各种活动,努力将系统保持在可容忍的工作状况边界内的结果。这些活动大部分情况下是正常操作的一部分,表面上看起来也很直接。但因为系统的运作从来都不是没有故障的,人类操作者对不断变化的运行条件的适应,实际上每时每刻都在创造安全。这些适应往往只是从现有的对策中选出一个已经反复排练过的程序;但有时,这些适应是对新方法的全新组合,甚至重新创造。
18. 无故障操作需要有故障经验
识别危险并成功操纵系统,使其留在可容忍的工作状况边界内(的能力),需要与失败有亲密的接触。在操作人员能辨别「包络边缘」的系统中,可能会产生更健壮的系统效能。(「包络边缘」)是系统的性能开始退化,变得难以预测,或无法轻易恢复之处。在内在危险的系统中,操作者应能面对并理解危险,并将系统导向理想的性能状态。提升安全性,取决于为操作者提供对危险的准确看法,也取决于让操作者准确了解他们的操作将如何影响系统性能,是朝向还是离开包络边缘。
14 - 分布式系统课程笔记
这学期选了一门分布式系统的课程,实际上内容大概是 MIT 的分布式系统(6.824)和普林斯顿的分布式系统(COS 418)课程的混合。大概覆盖了以下内容:
- 分布式系统基础:RPC 和消息语义,逻辑时钟,分布式快照,一致性模型, CAP/FLP 理论
- 最终一致性系统:Bayou, DHT, Dynamo
- 共识和状态机复制:Primary-backup, Viewstamped Replication, Paxos, Raft, P-BFT
- 分布式事务与强一致性:2PC, 2PL, Spanner
回想之前大一大二断断续续上的一些分布式相关的课程,有些东西果然是需要一些经验才会慢慢理解。
课程内容之外,作业基本上也是从 MIT 的作业改的,分别是实现以下系统:
- MapReduce (Sequential / Distributed)
- Raft (Election, Log Replication, Fault Tolerance)
- K-V Storage based on Raft (KV-Raft)
其中可能比较值得一提的是后两项作业,因为算是自己可能从来不会主动去写的类型,一想到可能的巨大复杂度就打退堂鼓了。不过实际上因为配套的测试比较完备,最后写起来其实也就是一个 case 一个 case 过,并没有想象中的那么困难。(不过从日志 debug 的确容易烦躁就是了。)最后实际上 Raft 和 KVRaft 都是在两天内写完的,不过的确是全神贯注的两天了。
尝试着把自己的(中文)笔记整理了一下,放在下面的链接。不过课件还是要点回课程网站手动获取,我并没有 redistribute 的权限。如有错漏,欢迎指出。 All distributed system lectures
总而言之,上完这门课并且写完作业,稍微算是对自己实现复杂系统的能力更有一些些信心了吧。
15 - 调用栈也是栈
又到了秋招的季节,刷题的时候遇到了一道有趣的题,简化如下:
定义一类字符串为 NB 串,每个 NB 串有一个对应的 NB 值
空串是一个 NB 串,且其 NB 值为 1
对一个 NB 串,在其两侧加上括号后依然是一个合法的 NB 串,且其 NB 值为原串 NB 值加 1
对两个 NB 串,将其拼接后依然是一个合法的 NB 串,且其 NB 值为两个原串 NB 值的乘积
问:给定一个已知合法的 NB 串,求其 NB 值
样例
看到括号,第一反应当然是用栈。先想了一会有没有只扫描一遍字符串的做法,但是很可惜没想出来。最后想了一个先构造树,再在树上遍历的做法,解答如下。
但是如果换个角度来看,其实题目描述的 NB 串,可以被视为是一个简单的类型定义,语法大致如下。然后要做的,就是把输入数据视作代码,构造抽象语法树,然后在语法树上操作得到结果了。
如果 OJ 提供了类似于 Haskell 之类内置支持模式匹配的语言,那么就很简单了:把输入 tokenize,写一个 calc 函数,然后直接按照题目要求写匹配规则和返回值就好了。伪代码如下。
然而现实并没有这么美好。但是难道就应该就此放弃吗?未必。实际上编程语言内的调用栈,也是一个栈,或者说语言本身就提供了我们所期望的解析语法树的功能。高人指点之下,可以用以下的 hack 来实现:
上文代码所做的,实际上就是把输入串,替换成了一系列函数调用,并添加了符合题目要求的函数体。最后只需要直接调用 Python 内置的 eval,就可以得到正确的答案了。
16 - Tensorflow 开发者认证记录
又名:我是如何在 7 天内通过 Tensorflow 开发者认证的,以及你应该这样做吗?
作者在 2021/7/4 参加考试。本文写于 2021/7/7。文中内容可能在未来发生变化。
下文简称 Tensorflow 为 TF,机器学习(Machine Learning)为 ML,深度学习(Deep Learning)为 DL。虽然 DL 在分类上而言是 ML 的一部分,但鉴于 DL 在各大领域取得的进展,常常将 ML 和 DL 并列。
TL;DR
- 7天(甚至更短时间内)通过 TF 开发者认证是可行的。
- 就实践水平而言,这一认证的含金量并不高(有点水),通过认证只意味着认证人具有基本的,使用 TF 进行图像分类/文本分类/时间序列预测任务的能力。
- 与其代表的实际水平相比,这一认证更大的意义可能在于强迫自己去阅读/学习,以及向潜在的雇主证明自己有能力/意向进行 ML/DL 的相关工作。
预备知识
这个证书是什么?
- Tensorflow 是一个 Google 创建的开源的 DL 框架,使用广泛,也在 Google 内部支持着许多服务
- Tensorflow Developer Certification 是 Google 的一个认证项目,在 2020 年 3 月开始,旨在证明认证人有能力使用 Tensorflow 建立 DL 模型,完成指定任务。
为什么你可能会想要这个证书?
- 通过考证的过程学习 ML/DL 的相关知识
- 向未来的雇主证明自己有意愿/有能力完成 ML/DL 相关的工作
考试如何进行?
报名费 $100,缴费后 180 天内需参加考试
5 小时时限,5 个任务,全部完成后可以提前结束
每个任务需要提交一个模型,可以随时提交,提交后几乎立刻可以得到一个五分制的反馈
不同任务的分值不同,但是没有明确列出。理论上要求总分在 90% 以上通过
每个任务包含题目描述和代码框架,并不是从零开始,更接近填空
因为模型需要在远端测评架构上进行评分,模型输入和输出是被严格限定的,主要能调整的是模型架构和训练过程
考试要求 Pycharm,但 Pycharm 实际上只是考试 UI,实际的模型建立/训练可以在其他设备/平台上进行(如 Colab,Jupyter Notebook),只需要把最后得到的模型文件(.h5)放回考试目录下即可
不限制网络使用,可以使用任何资源答题
考试失败后,需要间隔一段时间才能再次参加(首次 14 日,第二次一个月,第三次一年)
我的个人背景
- 我自己从大三开始,陆陆续续修了一些数据科学/深度学习相关的课程,但是除了课程作业之外没有多少实践。
- 自己之前主要使用的 DL 框架是 PyTorch,对于 TensorFlow 了解不多。
- 现在算是暑假期间,暂时有一些自己的空闲时间。
- 之前一直想通过读 HOML (Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow, 2nd Edition)来学习使用 TF 的知识,但是静不下心去强迫自己学习。
- 好奇 Google 会如何通过证书考试的形式量化开发者的能力。
我参加这一考试的目标
熟悉 TF 的架构和使用。
掌握使用 TF 构建 DL 模型,完成数据科学任务的全流程(从数据输入到模型在生产环境上线)。
能够完成常见的 DL 任务(图像/文本/时间序列/结构化数据)。
后文将会回顾这些目标的完成度。
考前准备
我首次听说这个考试是在 Daniel Bourke 的视频 (YouTube),主要使用的相关资料也主要参考了他的博客。此外,TFUG 苏州的这一视频讲解 (Bilibili) 及 微信公众号文章 也提供了一些帮助。
资源
以下资源按重要程度排序。
TF 开发者证书候选人手册(中文版 link,英文版 link) TF 开发者证书考试指导,TF 开发者证书考试环境配置(考前可从考试平台下载)
必须。《候选人手册》是最重要的官方文档,需要详细阅读。其中有一个技能清单(Skill Checklist),基本上也就是考试会覆盖的主要内容了。《考试指导》和《环境配置》两个文档在为考试缴费后才在考试平台上可见,建议在开考前先通读一遍,并试着自己建立环境,以避免开考后遇到环境配置问题。
在线课程《DeepLearning.AI TensorFlow Developer 专业证书》(Coursera, 课程 Notebook Repo)
必须。 实际上是四门课程的集合,分别覆盖深度学习基础、CNN、NLP和时间序列。和技能清单几乎完全重合(实际上课程主讲和证书发放签名人是同一位)。课程内有视频和在线测评环境,习题也和真正的考试试题差不多,基本上能跟着完成课程,考试也就不会有太大问题了。课程本身价格是 $59,但是有一周的免费试用(需要银行卡),可以快速刷完后取消付款方式关联。
书籍 (HOML)《Hands-On Machine Learning with Scikit-Learn, Keras, and TensorFlow, 2nd Edition》(中文版:《Scikit-Learn、Keras 与TensorFlow 机器学习实用指南(第二版)》)(O’Reilly ,书 NoteBook Repo)
推荐。 这本书更接近延伸阅读材料,内容本身超出考试很多,但是对构建知识体系更有帮助。有些内容在线课程里说的不是很清楚(如
tf.Dataset的使用),书里会有更详细的讲解。和考试相关的部分是第 10 章至第 16 章。我所在的学校购买了 O’Reilly 的电子订阅,因此我选择在 iPad 上进行阅读,但是也可以购买纸质版本阅读。可选。 教程类似于 Cookbook,有解决各种任务的示例。指南则更注重底层原理和基础知识。可以先浏览一遍目录,在遇到不懂之处的时候进行查阅。如有时间也可通读。
学习思路
面对这种多种资源覆盖同一主题的情况,一般有两种学习思路:
- 纵深:一次学习所有和这个主题相关的资源
- 重复:一次学习一个特定资源,在不同主题间重复
| 纵深 | 重复 |
|---|---|
 |  |
在 Daniel Bourke 的博客分享中,他使用的是纵深的学习思路(tribird approach,一石三鸟),每天选定一个主题,首先看对应的在线课程,然后阅读书籍,再花时间写代码练习,最后看 MIT 的视频收尾。但是根据我自己的经验,我更习惯于重复的学习思路,需要让大脑把知识在后台处理一段时间,才能找到一些没想清楚的地方,从而进一步学习。各位读者可以根据自己的习惯选择合适的路线。
学习时间线
Day 1:通读《候选人手册》,打印技能清单作为速查备忘。在考试平台上注册考试并缴费(需要提前完成,身份审核需要一段时间)。学习在线课程的前两个课程,完成课后习题。(学习时间约 8h)
Day 2:学习在线课程的后两个课程,完成课后习题。(学习时间约 10h)
Day 3:阅读书籍的 10 ~ 13 章并做笔记,同时查看相关笔记本的代码示例。(学习时间约 8h)
Day 4:阅读书籍的 14 ~ 16 章并做笔记,同时查看相关笔记本的代码示例。阅读 TF 官方指南中的「Keras」部分。(学习时间约 10h)
Day 5:阅读 TF 官方教程中的「Keras 机器学习基础知识」、「加载和预处理数据」、「图像」、「文本」、「结构化数据」部分。处理之前笔记中遗留的部分问题。开始尝试从零实现 Day 1 中的作业(首先复现,然后使用不同的数据集)。(学习时间约 12h)
Day 6:开始尝试从零实现 Day 2 中的作业。复现 TF 官方教程中的几个自己认为有趣的示例。尝试使用 Keras-tuner。根据环境配置文档准备准备考试环境。(学习时间约 12h)
Day 7:复习笔记。重新阅读《候选人手册》和《考试指导》。在 Pycharm 下复现一个之前的作业。(学习时间约 8h)
Day 8:参加考试。
学习建议
- 建立自己的 code snippet (代码片段)集合,在需要的时候可以快速查阅(常用的网络结构、常用的预处理代码、常用的 Callback…)
- 建立 checklist(检查清单),如
- 模型精度不符合预期的可能出错点(根据自己完成作业的经历建立)
- 过拟合的处理方式(根据自己的经验和阅读的相关资料)
- 保留所有自己写过的代码,以备查阅
设备与环境
我自己使用的是实验室内的工作站,GPU (Quardo M2000, 4G VRAM) 比较老旧,系统是 Ubuntu 18.04,Pycharm 版本 2021.1.3 Community。为了保险,考前在学校的超算上申请了一个 GPU 示例备用,GPU 为 RTX2080。
考试本身需要训练的模型其实都不会太大,根据《考试指导》中的描述,如果能在本地跑通 图像分类 和 文本分类 这两个示例,基本就不会有问题了。再加上有五个小时的时间,一般情况下是不用担心本地算力过低导致训练失败的。如果条件是在比较有限,可以使用 Colab 进行训练,或者是在主流的云厂商平台上购买带有 GPU 或是为深度学习优化过的实例。
考试是在 virtualenv 的虚拟环境中建立的,需要提前在系统级别安装 Python 3.8 版本。官方的《考试指导》中特别注明了不可以使用 Anaconda,不太确定原因,但是最好遵守。
需要注意的是,Pycharm 本身虽然可以设定使用远程 SSH 连接下的 Python Interpreter,但是这一配置是不受到考试插件支持的,因此最好直接在具有 GPU 的设备上安装 Pycharm 和考试插件。
网络环境方面,因为考试本身需要从 Google 的服务器下载数据集和上传模型,建议自行确保到国际互联网的连接质量,或是在网络低峰期参加考试。数据集在代码中使用 request 库进行下载,但是也可以手动使用其他工具下载后放置于考试目录内。
考试中
- 需要提前准备系统的 Python 3.8 环境,并在 Pycharm 内安装一个 TF Certification Exam 插件。
- 插件运行后首先需要登录 Google 账户认证,然后会自动创建 venv 并安装依赖。完成后显示「Start Exam」按钮,点击后即考试开始。
- 插件会自动建立一个 Pycharm 工程,其中有 5 个文件夹,命名为 Category1 到 Category5。每个文件夹内有一个
starter.py为基本的代码框架,内部有#TODO注释标注需要填写的部分。在编辑starter.py时,插件会自动显示本题的描述。 - 完成训练后,会在题目目录下生成
mymodel.h5文件。如果使用其他设备训练,也可以从其他设备下载模型文件后,手动放置到文件夹内(需要为 h5 格式)。在插件内选择Submit and Test model就会自动提交到服务器进行测评,右下角进度条会显示上传进度,一般上传完成后 30s 内就会返回评分(0/5 到 5/5)。如果太久没有返回评分,可能是模型过大/过复杂,可以取消当前测评。 - 可以无限次提交模型。测评本身是基于后台的一部分隐藏数据的,根据部分参加者的反馈,数据存在一定随机性,即使是同一模型的多次提交,返回的分数也可能存在浮动。
- 所有题目都拿到 5/5 评分后,即可点击插件,选择「End Exam」,确认后结束考试。
我自己的这一次考试比较幸运,因为事前自己根据《环境配置》文档验证过环境,没有遇到环境导致的问题。5 个题目都不是很难,我在开考后的 40 分钟就完成了 4 个题目并拿到 5/5,但是 NLP 的题目十分诡异,尝试了各种架构都只能得到 4/5 评分。最后换了优化器,调小学习率,增大 epoch 数慢慢训练,总算 5/5 了。最后结束考试的时候,还剩余 3 小时 10 分钟。
本次我遇到的 5 个题目是:
- 一个很简单的回归
- 一个你绝对已经遇到过多次的数据集的分类
- 图像分类
- 自然语言处理(文本分类)
- 时间序列预测
考试结束后
如果通过,几分钟内就会收到通过邮件,并可以填写信息注册到 Google 的认证网络。数字证书需要几个工作日才会通过电子邮件发送。
回顾与总结
回顾这一周,我认为这是一次有趣的经历。可能对我而言,花钱是强迫自己学习的有效方式,至少这一周我是好好把 HOML 中的部分章节给啃下来了。考试本身比想象中容易很多,更说明通过这场考试只是一个开始,仅仅证明自己具备了基本的,跟随教程完成部分简单任务的技能,但是离真正掌握还有很远。
之前我自己定下的目标的完成情况如下:
- 熟悉 TF 的架构和使用
- 完成(至少从完全没有经验到能快速上手构建原型了)
- 掌握使用 TF 构建 DL 模型,完成数据科学任务的全流程(从数据输入到模型在生产环境上线)
- 部分完成(本次学习主要覆盖的是从数据输入到模型建立,但是后续部署到生产环境没有怎么覆盖)
- 能够完成常见的 DL 任务(图像/文本/时间序列/结构化数据)
- 基本完成(每个大分类下都还有很多细分任务,本次学习只是覆盖了最基本的一些任务,但是作为基础知识与入门的介绍已经足够好了)
所以你应该参加这个认证吗?
在我看来,对于未来的计算机/数据科学专业的学生,ML/DL 的技能会被认为是「默认掌握」的。TF 的这个开发者认证,会更接近当前「计算机二级」认证的认可层级:对专业外的学生是额外技能的体现,对于专业内的学生则没有太大的意义。但是就当前而言,获得这一认证可能还是有其意义的,至少在一些小公司可能更容易让你通过 HR 筛。
表格:如果满足以下条件,你…参加这个认证
| 可能应该 | 可能不应该 |
|---|---|
| - 想强迫自己学点东西 - 从其他专业转行,需要证明自己的能力和求职意向 - 简历上没有太多能写的经历 | - 已经有了成熟、丰富的 ML/DL 经验 - 手头没有闲钱/时间 - 觉得 TensorFlow 太难用了,PyTorch 万岁 |
17 - 再次复活
2020 年发生了很多事,一直没有时间更新博客,然而突然意识到,很多有趣的事情、实用的技巧,并没有得到足够的分享,于是打算重新拾起这个博客。
把文件重新找回来
复活的第一步显然是把原始的部署文件找到。但是因为换的设备太多,加之保存文件习惯不加,找起来还是花了一些时间的。Onedrive 里虽然有一个版本,但是是之前用 Hexo 的版本,Hugo 版本的博客则是翻了全盘备份才找到的。(再一次凸显了全盘备份的重要性,不过根源大概还是因为 2020 年换了太多设备了)这次复活后,也会把用于生成静态网页的原始文件,使用 Github Private Repo 的方式加以备份,避免再难寻找。
换个主题
文件找回来之后,在本地就可以跑起来了。然而因为复活后的博客大概也需要承担一部分分享任务,当前的主题布局并不是很适合,主要是页面太空,各文章之间间距太大,于是寻思着换个主题。官网上找了找,发现了当前这款 Manis,列表页只有标题,相对更简洁一些。不过唯一有些遗憾的就是没有黑暗模式,之后再看看怎么加上吧。
更新文章
实际上之前虽然一直没有更新博客,私底下还是断断续续写了几篇的,于是就趁这个机会一起发上来好了。此外因为有两年没更新,有些博文也已经过时了,在此也一并加上了更新。
加入「分享」栏目
本次复活中,特意加上了「分享」这一栏目。之前旧不更新博客,原因之一就是每次写文章太累了。但我后来意识到,其实有些小技巧、小发现,也可以用博客进行分享,但是并不需要完整的文章,只是简短的摘要供参考就足够了。由此出发,便有了「分享」这一栏目,可点击标题栏「Share」查看。未来的计划大概是遇到什么有趣的东西,就随手在这里加以分享。
18 - 不丢失数据的重装 - Repair Install
本文原载于「小众软件论坛」link
前言
最近主力机上的 Windows 10 遇到了一些诡异的问题,开始菜单部分时候无法打开。这种系统层面的问题,第一反应当然是 sfc/dism 修复,然而无果。各种杂七杂八的方法也都去试了,故障依旧。事已至此,大概只有重装了,然而数据备份,软件安装,想想就头大。但是在偶然间发现了「Repair Install」(试译「修复安装」)这个小技巧,尝试后的确解决了问题。试着搜索了一下论坛,似乎还没有人介绍过,故作此贴。
什么是「Repair Install」
作为 Windows 用户的你可能没有听说过 Repair Install,但是大概率你已经体验过了:Windows 10 的大版本更新。在更新完成后,进入 「设置 - 系统 - 关于」,会发现「安装日期」已经被修改为了更新的安装日期。原因在于,Windows 10 的大版本更新,实际上就是一次保留了用户数据(含文件、应用和设置)的系统重装。这也是为什么大版本更新通常比一般更新耗时更长,且安装过程中会见到类似于全新安装的进度百分比显示。
换个方向思考,既然 Windows 更新机制可以允许这种特殊的保留用户数据的重装,是否可以让用户自己来进行呢?这实际上就是 Repair Install 的本质了:用户手动进行的“大版本更新”。 (此处“大版本更新”带引号,因为实际上并不要求安装介质的版本比已安装系统的版本高,相同版本也是可以进行的)
什么场景适合于「Repair Install」
当 Windows 10 出现了奇怪的问题,且其他途径无法修复时,包括但不限于:
- 开始菜单打不开
- UWP 应用打不开
- 字体/图标丢失
- 注册表混乱
进行「Repair Install」的前置要求
- 可以正常启动 Windows 进入桌面(如果已经启动不了就无能为力了,只能进安全模式也无法使用这个方法)
- 安装 ISO 需要和当前安装的系统:SKU(家庭/专业)相同、架构体系(x86/x64)相同、语言相同、且安装 ISO 版本高于或等于当前安装系统版本
- 当前系统分区有相对充裕的剩余空间( tenforums 的说法是至少 8.87 G,不过也不知道这个数字的来源。建议至少保留 15 G 以防重蹈 MacOS Big Sur 的覆辙。)
如何进行「Repair Install」
- 获取 Windows 10 ISO (可以使用微软官网的 Media Creation Tool 或第三方直链 TechBench by WZT (v4.1.1) (rg-adguard.net))
- 双击挂载 ISO (也可以用其他虚拟光驱工具)
- 进入挂载驱动器,运行
setup.exe - 一路下一步,在「选择要保留的项目」页选择「保留个人文件、应用和 Windows 设置」
- 耐心等待安装完成
参考链接
19 - 给 WSL 安装桌面环境
给 WSL 安装桌面环境
本文是旧文补完计划的一部分。
可能你需要运行一些只提供 Linux 版本的 GUI 程序,抑或是你厌倦了 VM 的启动/恢复等待,或者只是过年实在无事可做… 总之,你需要在 WSL 下安装一个桌面环境。希望这篇文章能够提供一些小小的帮助。
开始之前:对比 WSL 下的桌面环境与 Linux VM
DE: Desktop Environment 桌面环境
| DE in WSL | Linux VM | |
|---|---|---|
| 启动速度 | 即时可用 | VM 启动 / VM 状态恢复 |
| 配置难度 | 相对麻烦 | 简单,主流 Linux 发行版中都提供良好支持 |
| 资源消耗 | 少,仅额外添加 Win 端 XServer 消耗 | 多,需要考虑 VM Supervisor 的 overhead |
步骤
参考自:https://github.com/QMonkey/wsl-tutorial
其他链接:
我自己的环境:Windows 10 1909, WSL 1, Ubuntu 18.04
前置要求:配置好 WSL 1,发行版 Ubuntu 18.04
在 Windows 下安装 VcXsrv Windows X Server,安装过程中一路下一步即可。
在 WSL 中安装
xfce4,xfce4-terminal为什么用 XFCE:小,资源占用少,比较适合我们当前的需求
在 WSL 中配置
dbus修改
~/.bashrc,加入以下内容,随后运行source ~/.bashrc使其生效在 Windows 中运行
XLaunch(先前VcXsrv安装的一部分),在第一个配置页面选择One large window或者One large window without titlebar(区别是 Windows 下,DE 的显示窗口是否会有标题栏),随后一路下一步。在 WSL 中运行
startxfce4,观察 Windows 下VcXsrv是否正确启动。如果一切正常,此时应该会显示 Xfce 4 的默认壁纸,并开始 DE 初始化过程。
如果只是需要一个正常运行的 DE 的话,到此即可。以下步骤为添加中文支持(字体和输入法)。
在 WSL 中安装中文字体和
fcitx输入法框架,并生成systemdMachine ID加入输入法设定至
~/.profile更改
dbus配置让fcitx能正常启动:向/etc/dbus-1/session.conf中写入以下内容安装搜狗拼音
安装搜狗拼音的 deb 的时候,第一次会因为缺少依赖而失败,因此先用
-f补充缺失的依赖,再重新安装,就可以完成了。配置搜狗拼音:运行
startxfce4启动 Xfce,右键单击右上角「键盘」图标,选择 Configure。在打开的窗口中点击左下角「+」按钮,搜索并选中「Sogou Pinyin - Chinese (China)」(如果不想搜索可以直接拖到列表底部),点击「OK」完成添加。(可选)测试输入法:安装
gedit,并测试能否在其中正确输入中文。输入前,可能需要从右上角「键盘」图标选中 Input Method - Sogou Pinyin 作为当前输入法。
原理解析
为什么这个能 Work 呢?其实这就是上古时代的正确用法:Server 进行主要运算,Client 只作为操作终端,提供图形显示和输入。
20 - Utils.ahk
各种奇奇怪怪的小功能的集合… 大部分都是从其他的 AutoHotKey 开发者那里抄过来的…
快速启动
- Win+N 记事本
- Win+C cmd
- cmd下Ctrl+V直接复制
- Win+Alt+O explorer
- Win+Alt+K kill掉explorer (被注释禁用了 需要自己手动开启 line 221-228)
窗口透明度
来源:https://autohotkey.com/board/topic/148619-set-window-always-on-top-and-change-transparency/
- Alt+E 获取需要调整透明度的窗口
- Alt+W 增加透明度
- Alt+Q 减少透明度
记事本相关
- Alt+Shift+S 把所有无标题的记事本内容复制到一个新的记事本示例
- Alt+Shift+D 关闭所有无标题的记事本
窗口调整
来源:http://blog.sachleen.com/posts/1370369043/snapping-windows-vertically-on-portrait-display/
- Alt+T 当前窗口置顶
- Win+Alt+↑ 窗口占据上半屏幕
- Win+Alt+↓ 窗口占据下班屏幕
- Win+Ctrl+Alt+↑ 窗口占据上1/4屏幕
- Win+Ctrl+Alt+↓ 窗口占据下1/4屏幕
21 - 博客迁移记录
在之前的文章中有提及,因为各种原因,已经很久没有打理这个博客了,一直荒废到了几周前。本文主要记录从 Hexo 迁移到 Hugo,并配置 Terminal 主题的过程。
文章头
大部分静态博客解决方案都通过文章头记录文章元数据,例如标题、创建日期、分类、tag 等。在迁移前,我知道 Hugo 的文章头和 Hexo 略有不同,主要体现在时间格式、数组形式上。但是没想到,Hugo 对 Hexo 下的文章头依然能正常解析,Archive 中有几篇文章就是直接从旧博客中复制过来的。
多语言部署
Hugo 支持切换访问语言,具体而言,切换的是主题中的一些字符串。在配置的时候,虽然我在 zh-CN 语言环境下进行了设定,但是发现本地没有生效。查询后才发现,需要用 defaultContentLanguage 参数设定博客的主语言。
Section / 文章列表
Hugo 的官方文档中,支持一种名为 Section 的文章组织方案。在 content 文件夹下,可以建立不同的 section,再在其内部放置文章,从而实现一种类似于 category 的文章层级。但是在我自己测试的时候,虽然可以通过手动构造 URL 访问 section 内的文章,但却无法获取 section 的文章列表。经过一番折腾后,发现可能是 Terminal 主题的缺陷,这一主题在设定文件中要求手动指定主要 section,暗示其可能不支持多 section 架构。查阅文档后,可能原因是 Terminal 主题中缺失对 section 的相关 layout 文件。最后我将 themes\terminal\layouts\_defaults 下的 list.html 复制到根目录下的 layout\_default 文件夹下,再删除了一些过滤条件,总算魔改出了一个能用的 section 视图。后续可能会向主题作者提 issue,或者直接发起 Pull Request。
虽然迁移有点点麻烦,不过能复活,总归还是很开心的。
22 - 我最近在用什么软件?
看看时间,从换电脑到现在已经3个月了,装的软件也在不知不觉间越来越多。此文用于推荐一些我觉得不错的软件,顺带也是作为备忘。有的软件没有被我列出,可能并不是因为我觉得它们不够优秀,而是我认为他们已经很知名了,不需要我再单独发文推广。
Featured ✨
Stickies
Sticky Notes++。初见只以为和其他的简单便利贴软件一样,但是用起来却发现越用越离不开了:Stack, Solo, 富文本支持, 自带 to do 转换… 当然,最重要的是数据安全,以及启动速度比 Windows 自带的便笺快太多了。自从用了 Stickies,我打开的 Notepad 窗口大幅减少了。
为了解决移除外接屏幕后便利贴无法访问的问题,甚至自带 Rescue Off-screen 功能。
注:此前苦于 Windows 下没有合适的速记类应用,我用 Notepad 和自己写的 AHK 插件作为解决方案。按下 Win+N 即可召唤出新的 Notepad 窗口,再按下 Alt+N 即可置顶,从而实现简单的速记效果。当然,长期使用后会导致 Notepad 窗口数暴增,且不便于保存和整理,在系统崩溃时也有数据安全之虞。
Snipaste
Snip 截图,Paste 贴图。描述看起来简单,用起来却格外使用,能够在狭小的电脑屏幕上模拟出在桌上工作时随意放置各种参考资料的快感。
Utools
Windows 版本的 Spotlight,一经发现就占据了我的 Alt+Space。在发现它之前,我用 Windows 自带的搜索,但是总是困扰于索引速度和作为干扰的网页搜索。有了 utools 之后总算是情景了。顺带还有插件支持。
MobaXTerm
作为 term 类应用,自然少不了连接远程服务器的功能,但 MobaXTerm 能做的却还有很多:文件传输、服务器性能监控、一键分屏、X11 映射、自带关键词高亮… 最重要的,是 Home 用途免费!
v12 在我的环境下表现不佳,偶有崩溃。v11 似乎更稳定一些。
GridMove
简单的分屏应用,但是支持复杂的自定义布局。尤其适合那种一边看书/教程/论文,一边做笔记的场合。当然,你也可以随意修改配置文件,让它融入你的工作流。支持多屏。
Listed 📜
- Hourglass: 有自然语言支持的倒计时器。用来提醒我去取洗/烘干了的衣服。
- Listen1: 一个软件听全网歌曲,不用担心版权孤岛。(网易云音乐也有类似插件,可用网易云音乐作为前端)
- WinDynamicDesktop: 定时更换 Windows 壁纸,实现伪 Dynamic Desktop 效果
- Draw.io: 画流程图/结构图/各种图的唯一指定软件,Visio 的强大开源替代品。
- NoteHighlight: Onenote 桌面版本插件,用来给笔记中的代码做代码高亮。
- MiKTex: 更现代的 Latex 解决方案,支持按需安装 package,至少比 TeX Live 小多了。
- Icecream PDF Editor: 免费的 PDF 编辑工具,Adobe 家对应工具的实用替代。
- ScreenToGif: Gif 录制工具,轻量好用。
- LockHunter: 专治
文件被占用,无法删除,界面比 Unlocker 更好看,且能指出占用进程。 - 弹弹 Play: 带弹幕的播放器。支持抓取在线视频站弹幕,也可从中心服务器为离线视频加弹幕。
- PDF-XChange Viewer: 带强大标注功能和需多实用工具的 PDF 查看器。启动比 Adobe Reader 快太多了。
- hfs: 当你需要一个临时的,支持上传下载的 HTTP 文件服务器时…
- PanDownload: 百度网盘下载加速。
- Video Speed Controller: (浏览器插件) 快速跳过视频废话,顺带可以练习英语听力?
Why?
常常有人问我:「装这么多软件用得着吗? 」、「为什么你的托盘区域有 20+ 图标?」
我的回答是:「因为我希望,当我在处理任务时,身旁总能有趁手的工具。」
23 - 耶[ ]复活啦!
标题用了一个梗,你能看出来吗?
(尽管我尝试以乐观的方式开场,但这对本篇文章的基调并无改善。)
转眼间大二已经结束了,大学生涯也已经过去一半了。之前一直拖着,现在也总算是趁着放假重新把博客捡起来了。趁此机会,顺便也尝试着做做自省吧。
关于博客
从 Hexo 切换到了 Hugo,在 Terminal 主题的加持下看起来似乎美观了很多,但转换和部署过程倒是有不少坑,之后可能单独开一篇文章来描述。趁着这次转换,也对旧的文章进行了一些处理,一小部分扔在了 Archive 里头,剩下的本地归档不再放出了。CSDN 上的部分文章估计会择日迁移过来,例如吐槽和 Leetcode 系列,不过 ETA 依然未知。
关于自己
迁移的时候回顾了下大一上结束时的自己写的近况报告,当年的自己看起来似乎乐观的多。然而现在的我似乎已经没有过去的那种勇气和魄力了。可能是受了早些时候的某件事的影响?但我也不知道。从大一下到大二下结束,上了不少课,写了不少作业,也尝试着做了不少事,但是却依然感觉自己相比大一上而言,并没有多少进步,反倒越来越迷茫了。
或许在这里,堆积文字并不是好的表述方法,如果用列表写出来反倒可能会好一点。那就试试看吧。
- 感觉失去了探索的勇气。
- 感觉心沉不下来,什么都想做但是什么都不敢做,什么都想学但什么都学不会。
- 越来越怕麻烦了,更期望用现有的东西堆砌出一个“能用”的东西,而不是创造一个“优雅”的解决方案。
- 惧怕重构和更新,固守已有的旧知识。
- 学的时候浅尝辄止,感觉自己懂了但是实际上并没有,用的时候仍然是边用边查,捉襟见肘。
- 对未来一片迷茫。担心自己的能力是否能够支撑自己在工业界活下去,又对学术界所必须的学习能力和数理基础缺乏信心。
- 代码和工程能力低下,且没有任何进步。两年过去了,我写出来的代码和我大一上写的依然没有多少区别,同样的混乱和不可维护,甚至可能因为忘记了一些特性反而更加糟糕了。
- 越发不敢与其他人交流,日趋自闭。
列举的时候一般都会带上一些示例,此处也不妨放上一些,反正它们也已经喷涌而出了。以下的每一条,都能让我想到另外的正面例子,但是我却感觉自己做不到了。
- 大一开始前我对编程语言并没有什么了解,大一上学习到了 Java,后来也就把 Java 作为了第一语言。这并没有问题,但是似乎因为有了一门主语言,就似乎没有耐心或者说心境去学习一些新的语言了。例如虽然我可以说自己能写 Python, C, C++, Javascript, Go,但是实际上每一种都只是会一些皮毛,任何一个有正常智商的程序员在接触这些语言的第一个小时内就能达到和我相同的水平。这样的语言学习,在我看来并没有多少意义,但是我却找不到沉进去学习的策略。
- 依然是 Java。平心而论,现在的我知道的 Java,和大一上结束的我知道的 Java,并没有任何增加,甚至反而可能还减少了。大二下 Java 2 的课堂上,很多东西我也是刚刚了解,就要尝试着教给同学们,实在是惭愧。一直说着要读核心技术之类的书籍,但是也一直停留在口头说说的地步。就算读了一部分,也因为没有进行过任何代码实践而早就忘光了。就现在我的水平,不光说我的同级生,很多大一的佼佼者都可以远远超过了,无论是在知识的深度还是广度上。
- 无法通过自学理解复杂概念,更别提工期紧张的时候了。多线程和异步看了很多,感觉会了,自己依然写不出来,但是又静不下心去学。每次都说着要学 Vue,但是到了要用的时候依然是靠 Bootstrap 和 JQuery 救场。大一上我在用 Spring Boot,到了大二下我也只会 Spring Boot,而且依然是当作黑箱,内部原理依旧是一无所知。说着
Project-based Learning,但是工期一紧就更学不进去了,只是想如何赶快把要做的东西拼凑出来。做了再多的 Project,也只是在堆砌其他人也能写的东西。 - 既有项目的维护:捐款系统的自动化、舍友系统的算法更新和验证… 感觉已经完全没有动力、勇气和信心去做了,更别提开新坑了。
- 大部分同学在这个暑假都已经联系导师,开始搬砖了,自己的却依然没有着落。找借口说自己需要时间探索和选择,但是也没有真正去了解过多少老师。对于未来更有发展潜力的方向:AI, CV, NLP, Robotics 更是直接丧失了信心。我知道他们前途远大,但是我就是认为自己学不下去。
- 数据科学… 尽管学了三门课,其中两门考的还不错,但是我依然只会最简单的单层调包和基于运气的调参,对分析和其他操作依然是一头雾水。神经网络之类的就更不用提了,完全苦手。
- 暑假,其他同学刷题的刷题、搬砖的搬砖、准备英语、学车。但自己却无所事事,每天不过都是在咸鱼中度过罢了。
这大概就是那种绝望感吧,让我想起了初中一千米自己跑在全班最后,看着所有人往前狂奔,自己却精疲力竭,越来越远的感受。
未来?
核心问题应该还是导师吧,但是我并没有什么解决的思路。我也不知道…
暂且作本文已立此存照吧。